
گوگل عرضه مدلهای جدید Gemini 3.8 Flash TTS و Flash-Lite TTS را آغاز کرده است؛ مدلهایی که قابلیت تبدیل متن به گفتار جمینای را طبیعیتر و قابلکنترلتر میکنند. شبیهسازی صدا با جمینای نیز امکانپذیر شده و مدل Flash TTS میتواند با دریافت تنها ۳۰ ثانیه نمونه صوتی و پس از احراز مجوز استفاده، صدایی سازگار با نمونه ایجاد کند.
🔷 شبیهسازی صدا با جمینای تنها به ۳۰ ثانیه نمونه صوتی مجاز نیاز دارد.
🔷 مدل Gemini 3.8 Flash TTS از بیش از ۱۰۰ زبان و گویش پشتیبانی میکند.
🔷 کاربران میتوانند احساس، لهجه، سرعت، مکث، خنده، زمزمه و نحوه اجرای متن را کنترل کنند.
🔷 مدلهای جدید امکان اجرای مکالمه دو نفره با صداهای ثابت را فراهم میکنند.
🔷 گوگل از SynthID، استاندارد C2PA و بررسی رضایت صاحب صدا برای کاهش سوءاستفاده استفاده میکند.
یکی از قابلیتهای اصلی Gemini 3.8 Flash TTS بازتولید صدای مجاز افراد است. این مدل میتواند با یک نمونه صوتی ۳۰ ثانیهای صدایی سازگار با صدای موردنظر ایجاد کند؛ البته گوگل داشتن اجازه برای استفاده از آن صدا را الزامی کرده است.
قابلیتهای مدل جدید تنها به شبیهسازی صدای موجود محدود نمیشوند. کاربران میتوانند یک صدای کاملاً جدید را نیز با توضیح متنی و زبان طبیعی طراحی کنند. گوگل همچنین بیش از ۲۰۰۰ صدای آماده را ارائه میکند.
مدل Flash TTS از بیش از ۱۰۰ زبان و گویش پشتیبانی میکند؛ موضوعی که دامنه استفاده از آن را برای تولید محتوای صوتی چندزبانه گسترش میدهد.
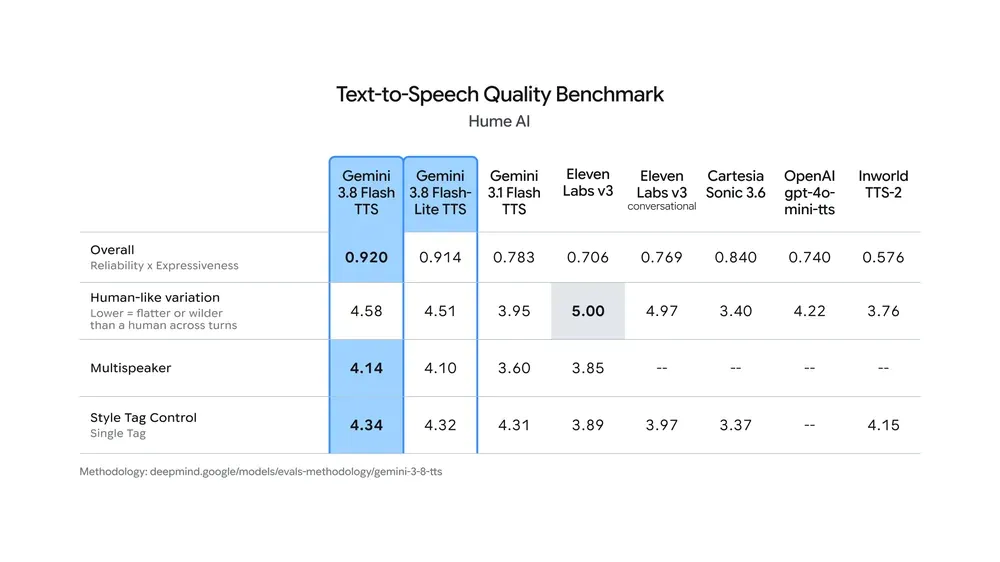
عملکرد برتر Gemini 3.8 Flash TTS در بنچمارک کیفیت تبدیل متن به گفتار
قابلیتهای صوتی جدید جمینای فراتر از خواندن ساده یک متن هستند. هر دو مدل میتوانند دستورالعملهای جداگانه برای خطوط مختلف یک سناریو را دنبال کرده و لحن، سرعت گفتار، لهجه و احساس را براساس دستور کاربر تغییر دهند.
مدلها همچنین نشانههای مکالمهای مانند زمزمه، خنده، آهکشیدن و مکث را اجرا میکنند. بهعنوانمثال، تولیدکننده محتوا میتواند مشخص کند یک جمله با لحن خاصی بیان شود و جمله بعدی حالت احساسی متفاوتی داشته باشد.
گوگل امکان اجرای مکالمه دو نفره را نیز فراهم کرده است. کاربر میتواند یک سناریو را در اختیار جمینای قرار دهد و مدل نقش دو گوینده را با صداهای مجزا اجرا کند.
یکی دیگر از قابلیتهای مهم مدلهای جدید، حفظ ثبات صدا طی چندین ساعت محتوای صوتی است. تغییر ناخواسته ویژگیهای صدا در محتوای طولانی میتواند استفاده از مدلهای تبدیل متن به گفتار را دشوار کند.
این ویژگی میتواند برای تولید پادکست، کتاب صوتی، دوبله، ویدئوهای روایتشده و دستیارهای صوتی کاربرد داشته باشد. کنترل دقیق اجرای متن نیز کمک میکند صدای تولیدشده حالت مکانیکی کمتری داشته باشد.
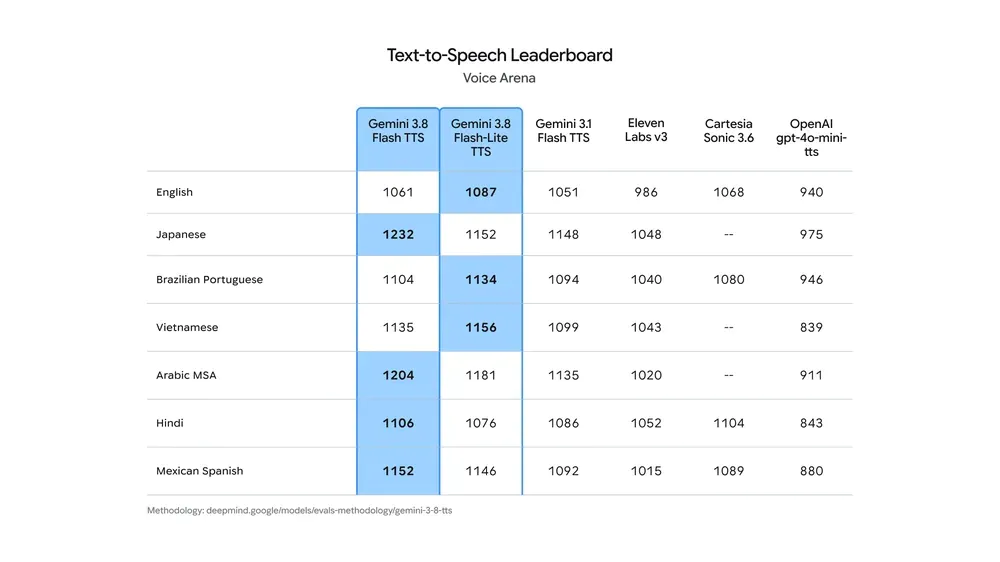
عملکرد Gemini 3.8 Flash TTS و Flash-Lite در زبانهای مختلف Voice Arena
مدل Gemini 3.8 Flash TTS در Voice Design Benchmark متعلق به Hume AI رتبه نخست مجموع را کسب کرده و امتیاز ۶۰.۸ را در بخش لهجهها بهدست آورده است.
مدلهای Flash و Flash-Lite نیز دو جایگاه اول شاخص کلی کیفیت Hume را کسب کردند. آزمایشهای Voice Arena نیز این مدلها را در چندین زبان در میان گزینههای برتر یا نزدیک به صدر قرار دادهاند.
بااینحال، ElevenLabs در بخشهای جداگانه کیفیت صدا و تنوع گفتاری شبیه انسان در ارزیابی Hume امتیاز بالاتری کسب کرده است.
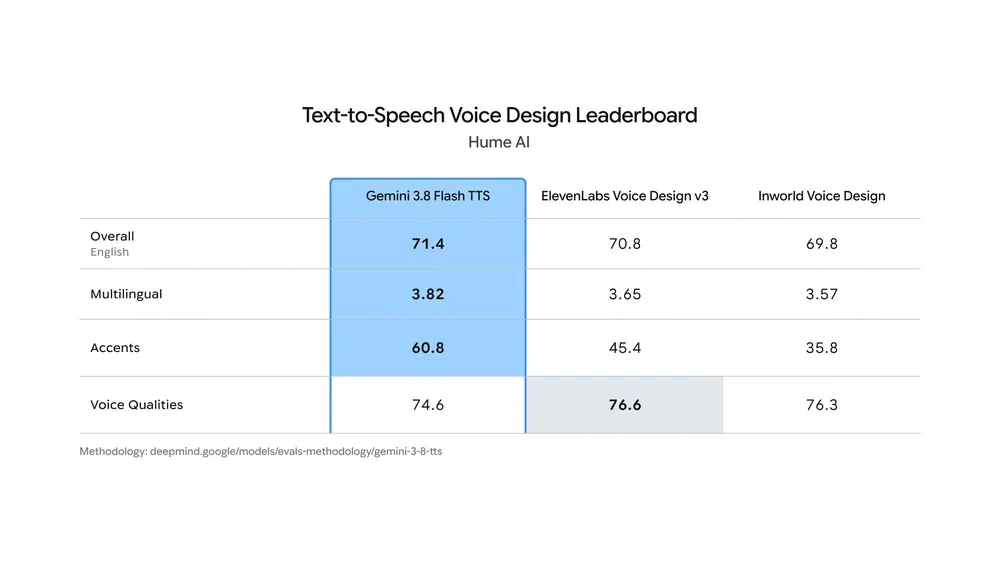
برتری Gemini 3.8 Flash TTS در بنچمارک طراحی صدای Hume AI
🔴 همچنین بخوانید: گوگل Gemini 3.8 Live را معرفی کرد؛ دستیار هوش مصنوعی حالا همزمان فکر میکند و صحبت میکند
گوگل ارائه Flash TTS در Gemini Notebook را آغاز کرده است. مدل Flash-Lite TTS نیز به Google Vids راه پیدا میکند. توسعهدهندگان میتوانند به هر دو مدل ازطریق Gemini API و Google AI Studio دسترسی داشته باشند و قابلیتهای تبدیل متن به گفتار را در محصولات خود بهکار بگیرند.
امکان تقلید صدای افراد میتواند خطرهایی مانند جعل صوتی و جعل هویت ایجاد کند. گوگل برای شبیهسازی صدا با جمینای مجموعهای از محدودیتها و ابزارهای تشخیص محتوای تولیدشده با هوش مصنوعی را درنظر گرفته است.
قابلیت شبیهسازی صدا در Google AI Studio در چند منطقه ازجمله بریتانیا، منطقه اقتصادی اروپا (EEA)، هند و ایالتهای تگزاس و ایلینوی آمریکا در دسترس نیست.
مدل Gemini 3.8 Flash TTS تبدیل متن به گفتار را از خواندن ساده سناریو فراتر میبرد و امکان طراحی یا شبیهسازی صدا و کنترل جزئیاتی مانند احساس، لهجه، مکث و سرعت را فراهم میکند. پشتیبانی از مکالمه دو نفره و حفظ ثبات صدا در محتوای طولانی نیز استفاده از آن را برای پادکست، دوبله و کتاب صوتی امکانپذیرتر میکند.
بهنظر شما قابلیت شبیهسازی صدا با هوش مصنوعی بیشتر برای تولید محتوا کاربرد خواهد داشت یا خطر جعل صوتی را افزایش میدهد؟ دیدگاه خود را در بخش نظرات بنویسید.