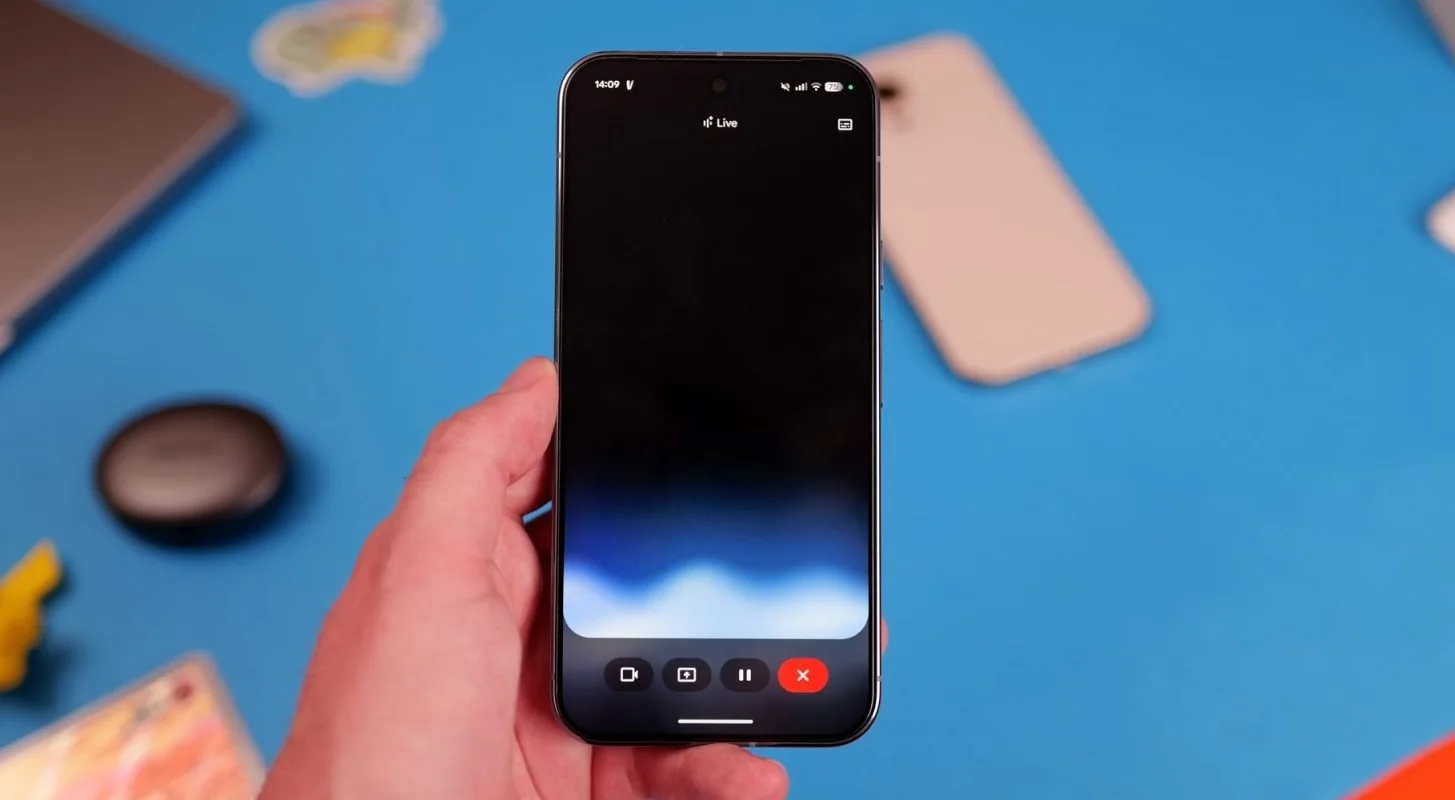

گوگل نسل جدید هوش مصنوعی Gemini 3.8 Live را با تمرکز بر مکالمه طبیعی و تقریباً بلادرنگ معرفی کرد. این مجموعه شامل مدل استاندارد Gemini 3.8 Live و نسخه پیشرفتهتر Gemini 3.8 Live Extended Thinking است که برای انجام وظایف پیچیده و چندمرحلهای طراحی شدهاند.
گوگل میگوید دو مدل جدید با هدف کاهش مکثهای ناخوشایند و رفتوبرگشتهای خشک در مکالمه با دستیارهای هوش مصنوعی توسعه یافتهاند. Gemini 3.8 Live روی مقیاسپذیری بالا و کاهش هزینه تمرکز دارد، در حالی که Gemini 3.8 Live Extended Thinking برای وظایفی ساخته شده است که به استدلال عمیق و چندمرحلهای نیاز دارند.
این مدلها میتوانند ابزارها و فراخوانیهای API را در پسزمینه اجرا کنند و در همان زمان به مکالمه با کاربر ادامه دهند. به این ترتیب، اجرای یک عملیات طولانیتر لزوماً باعث سکوت یا توقف مکالمه نمیشود.
یکی از قابلیتهای مهم Gemini 3.8 Live پردازش تقریباً بلادرنگ ورودیهای تصویری است. مدل میتواند آنچه را که از طریق تصویر میبیند بررسی کند و درباره آن به پرسشهای کاربر پاسخ دهد.
این مدل همچنین میتواند بهصورت خودکار میان ۹۷ زبان پشتیبانیشده در میانه جمله تشخیص زبان دهد و مکالمه را به زبان جدید ادامه دهد؛ قابلیتی که میتواند در گفتوگوهای چندزبانه کاربرد داشته باشد.
در نسخه Gemini 3.8 Live Extended Thinking، فرایند استدلال و مکالمه میتوانند بهصورت همزمان انجام شوند. مدل در هنگام دریافت داده یا اجرای عملیات در پسزمینه، لزوماً سکوت نمیکند و میتواند با عباراتی طبیعی مانند «اجازه بدهید آن را بررسی کنم…» روند کار را برای کاربر توضیح دهد.
گوگل در نمونههای منتشرشده، توانایی این مدل را در تبدیل طرحهای دستی اولیه یک مقاله به کامپوننتهای قابل اجرا در React، مدیریت فرایندهای پیچیده رزرو رستوران از طریق فراخوانیهای ناهمگام و راهنمایی کاربر در عیبیابی زنده در Google Search نمایش داده است.
گوگل اعلام کرده است که Gemini 3.8 Live Extended Thinking در شاخص کیفیت گفتار به گفتار Artificial Analysis با امتیاز ۸۲٫۶ در جایگاه نخست قرار گرفته است.
این مدل همچنین در برخی ارزیابیهای مربوط به عاملهای هوش مصنوعی عملکرد بالایی داشته و در بنچمارک τ-Voice به امتیاز ۶۸٫۶ درصد و در نسخه بانکی τ-Voice شرکت Sierra به ۳۵٫۱ درصد رسیده است. امتیاز آن در Big Bench Audio نیز ۹۷٫۷ درصد اعلام شده است.
مدل استاندارد Gemini 3.8 Live نیز رتبه دوم را در Speech Agent Arena به دست آورده است. گوگل همچنین میگوید مدلهای جدید در EVA-Bench شرکت ServiceNow توانستهاند در فرایندهای پیچیده، میان دقت و روانی مکالمه تعادل ایجاد کنند.
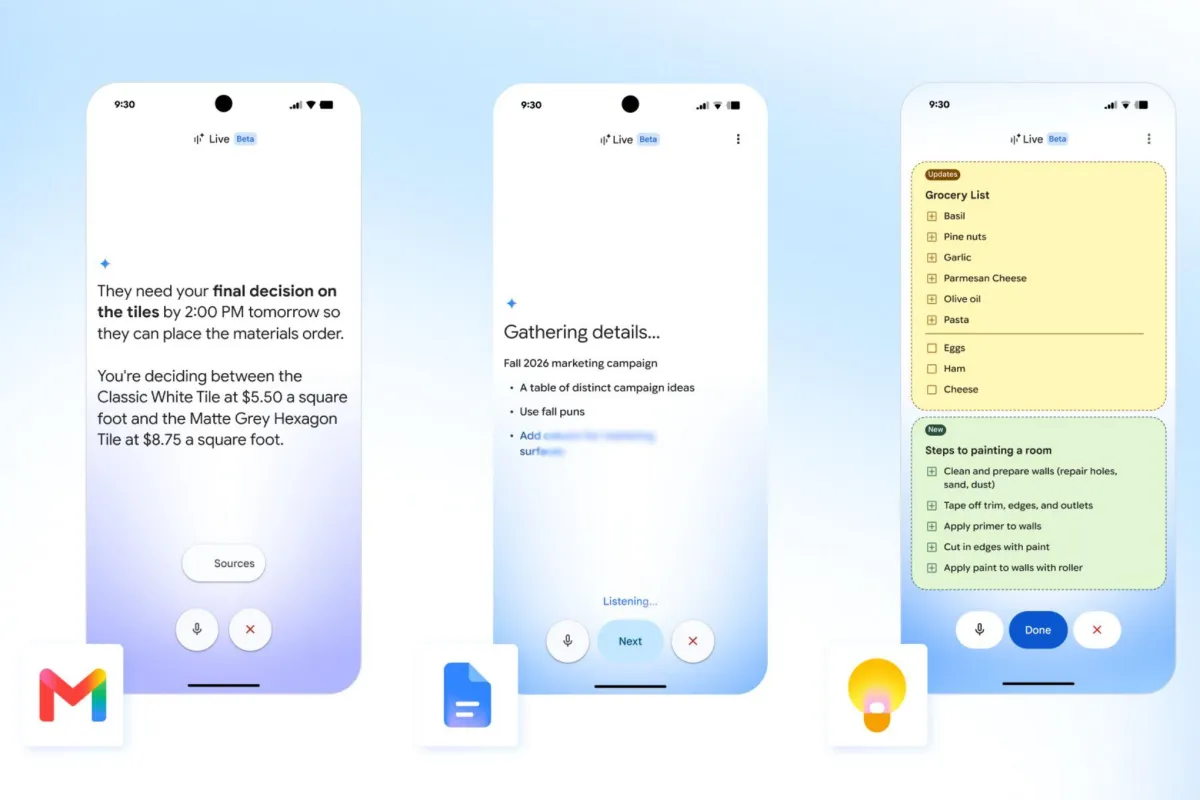
به گفته راجان پاتل، معاون مهندسی بخش جستوجوی گوگل، Gemini 3.8 Live هماکنون بهصورت جهانی در قابلیت Search Live در دسترس قرار گرفته است. کاربران پولی Google Workspace نیز قابلیتهای Extended Thinking را در برنامههایی مانند Docs، Gmail و Keep دریافت میکنند.
🔴 همچنین بخوانید: شرکت OpenAI مدل صوتی GPT-Live-1 را برای توسعهدهندگان در API عرضه کرد
توسعهدهندگان میتوانند مدلهای جدید را از طریق Gemini Live API و اتصالهای WebSocket دارای وضعیت به کار بگیرند. این API از صدای خام ۱۶ بیتی PCM با نرخ نمونهبرداری ۱۶ کیلوهرتز و تصاویر JPEG با حداکثر یک فریم در ثانیه پشتیبانی میکند و خروجی صوتی را با نرخ ۲۴ کیلوهرتز ارائه میدهد.
شرکتهایی مانند LiveKit، Vercel، Pipecat و Agora زیرساختهای مربوط به پخش و انتقال رسانه را برای این فناوری مدیریت میکنند. در بخش سازمانی نیز شرکتهایی مانند Salesforce، Genspark و Lumeris در حال آزمایش فناوری جدید گوگل هستند.
گوگل برای افزایش قابلیت تشخیص محتوای صوتی مصنوعی، تأیید کرده است که تمام فایلهای صوتی تولیدشده توسط این مدلها به واترمارک نامحسوس SynthID مجهز میشوند. این واترمارک مستقیماً در خروجی صوتی قرار میگیرد و با هدف آسانتر کردن شناسایی صدای تولیدشده توسط هوش مصنوعی به کار میرود.
هوش مصنوعی Gemini 3.8 Live گام جدید گوگل برای ایجاد مکالمههای طبیعیتر و سریعتر با دستیارهای هوش مصنوعی محسوب میشود. قابلیت اجرای عملیات در پسزمینه، پردازش تصویر، پشتیبانی از زبانهای متعدد و استدلال همزمان در نسخه Extended Thinking، محور اصلی این نسل از مدلهای صوتی Gemini هستند.
🔴 همچنین بخوانید: گوگل مدل جمینای 3.8 Flash را تنها سه هفته پس از نسخه قبلی منتشر کرد
نظر شما درباره قابلیتهای Gemini 3.8 Live چیست؟ آیا مکالمه تقریباً بلادرنگ میتواند تجربه استفاده از دستیارهای هوش مصنوعی را متحول کند؟