
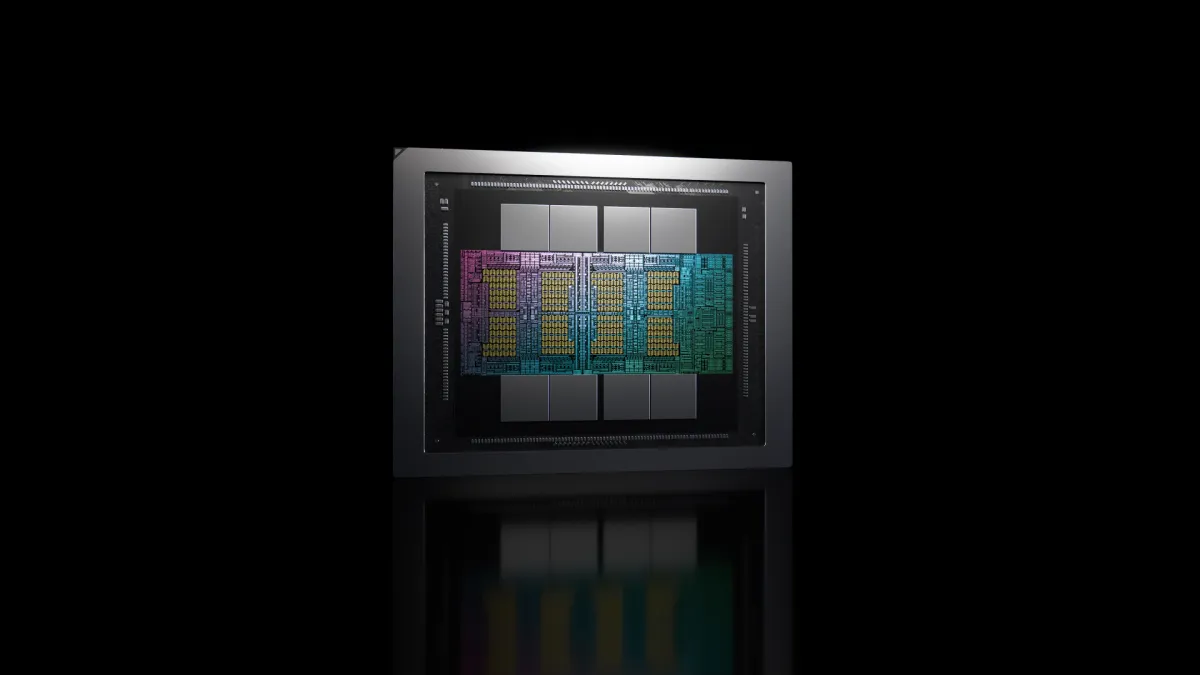
شرکت انویدیا در جریان کنفرانس ابررایانش SC26 از پردازنده گرافیکی جدید خود با نام Rubin HPC رونمایی کرد؛ تراشهای که بهطور اختصاصی برای محاسبات با کارایی بالا (HPC)، شبیهسازیهای علمی پیچیده و تحلیل دادهها طراحی شده است. این پردازنده که بیش از ۵۰ هزار هسته CUDA را روی یک تراشه واحد جای داده و از اتصال NVLink نسل هفتم بهره میبرد، طبق برنامهریزیها در سال ۲۰۲۸ روانه بازار خواهد شد.
🔷 انویدیا پردازنده گرافیکی Rubin HPC را در کنفرانس SC26 برای محاسبات علمی و شبیهسازیهای سنگین معرفی کرد.
🔷 این تراشه با داشتن بیش از ۵۰ هزار هسته CUDA، تقریباً ۲.۵ برابر کارت گرافیک RTX 5090 هسته دارد.
🔷 برخلاف مدل استاندارد روبین که بر هوش مصنوعی تمرکز دارد، Rubin HPC برای پردازشهای علمی عمومی بهینهسازی شده است.
🔷 پشتیبانی از NVLink نسل هفتم و شتابدهی دادههای پراکنده سرعت ارتباط میان پردازندهها و تغذیه هستهها را افزایش میدهد.
🔷 انویدیا هنوز مشخصات دقیق حافظه، مصرف انرژی و قیمت این محصول را منتشر نکرده و عرضه آن در سال ۲۰۲۸ انجام میشود.
پردازنده گرافیکی Rubin HPC بخشی از پلتفرم Vera Rubin انویدیا محسوب میشود، اما برخلاف مدلهای متمرکز بر آموزش و استنتاج هوش مصنوعی، بهطور ویژه برای بارهای کاری متکی بر محاسبات عمومی GPU بهینهسازی شده است. به گفته انویدیا، این تراشه عملیات رایج در علوم محاسباتی از جمله محاسبات ماتریسهای پراکنده، محاسبات استنسیل (Stencil)، مرتبسازی و کاهش داده را شتاب میبخشد که در حوزههایی مانند مدلسازی اقلیمی، تحلیل ژنومیک، شبیهسازیهای مهندسی و ارزیابی ریسک مالی کاربرد حیاتی دارند.
این پردازنده همچنین با کتابخانههای CUDA-X انویدیا یکپارچه میشود که پیادهسازیهای بهینهشدهای از الگوریتمهای پیچیده را در اختیار ایجنتهای هوش مصنوعی قرار میدهند. انویدیا استدلال میکند که شبیهسازی سریعتر، چرخه آزمایش یک ایده، ارزیابی نتایج و اصلاح گام بعدی را کوتاهتر میکند؛ بهویژه در زمینههایی مانند علم مواد، پژوهشهای مولکولی و طراحی صنعتی که ایجنتهای هوش مصنوعی نامزدهای متعددی را برای ارزیابی تولید میکنند.
ایان باک، معاون بخش ابرمقیاس و محاسبات با کارایی بالای انویدیا، در این باره اظهار داشت: «برای ایجنتهایی که در حوزههای علم و مهندسی فعالیت میکنند، شبیهسازی سریعتر به معنای کشف سریعتر است.» هدف این تراشه کمک به پژوهشگران و مهندسان برای بررسی گزینههای بیشتر و هدایت فعالیتهای آزمایشگاهی به سمت امیدوارکنندهترین موارد است.
انویدیا تاکید دارد که این پردازنده گرافیکی برای ایجاد تعادل میان قدرت محاسباتی و جابهجایی دادهها طراحی شده است. Rubin HPC به جای افزایش صرف ظرفیت محاسباتی، از فناوری شتابدهی دادههای پراکنده بهره میبرد تا هستههای CUDA را پیوسته با داده تغذیه کند و مانع از معطل ماندن آنها در انتظار عملیات حافظه شود.
علاوه بر این، تراشه جدید از فناوری اتصال داخلی NVLink نسل هفتم انویدیا استفاده خواهد کرد. این فناوری برای بهبود ارتباط میان پردازندههای گرافیکی (GPU-to-GPU) در سیستمهای بزرگ طراحی شده است؛ جایی که چندین شتابدهنده بهصورت همزمان روی شبیهسازیها و تحلیلهای سنگین کار میکنند.
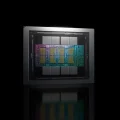
پردازنده گرافیکی Rubin HPC انویدیا
انویدیا تاکنون مشخصات کامل این پردازنده گرافیکی از جمله ظرفیت حافظه، پهنای باند، میزان مصرف انرژی، توان محاسباتی دقیق (مانند FP64)، قیمتگذاری و سیستمهای میزبان آن را منتشر نکرده است.
برای مقایسه، پردازنده گرافیکی استاندارد روبین به ۲۸۸ گیگابایت حافظه HBM4، حداکثر ۲۲ ترابایت بر ثانیه پهنای باند حافظه و فناوری NVLink نسل ششم با پهنای باند دوطرفه ۳.۶ ترابایت بر ثانیه مجهز است، اما نباید فرض کرد که این مشخصات عیناً در نسخه Rubin HPC نیز تکرار میشوند. با این حال، داشتن بیش از ۵۰ هزار هسته CUDA به این معناست که تراشه جدید تقریباً ۲.۵ برابر کارت گرافیک ردهبالای RTX 5090 (که دارای ۲۱٬۷۶۰ هسته CUDA است) هسته پردازشی دارد. انتظار میرود عرضه Rubin HPC در سال ۲۰۲۸، یعنی حدود دو سال پس از معرفی نسل استاندارد روبین آغاز شود.
معرفی تراشه Rubin HPC نشان میدهد که انویدیا در کنار تمرکز گسترده بر بازار هوش مصنوعی مولد، نیازهای جامعه علمی و مراکز ابررایانش را نیز فراموش نکرده است. ترکیب بیش از ۵۰ هزار هسته CUDA، مدیریت هوشمند جریان دادههای پراکنده و اتصال پرسرعت NVLink نسل هفتم، این پردازنده را به ابزاری قدرتمند برای شتابدهی به اکتشافات علمی مبتنی بر هوش مصنوعی در سال ۲۰۲۸ تبدیل خواهد کرد.
به نظر شما تمرکز ویژه انویدیا بر ترکیب شبیهسازیهای علمی کلاسیک با ایجنتهای هوش مصنوعی در تراشههایی مانند Rubin HPC تا چه اندازه میتواند سرعت کشف مواد و داروهای جدید را متحول کند؟