
مدل Qwen 3.8-Omni-Flash بهعنوان نخستین مدل چندوجهی Qwen که بهطور مشخص برای ایجنتهای هوش مصنوعی طراحی شده، معرفی شده است. این مدل میتواند صدا و ویدیو را بهصورت همزمان پردازش کند، از محتوای آنها نتیجه بگیرد و با استفاده خودکار از ابزارها کارهایی مانند ویرایش ولاگ، ترجمه ویدیوهای کوتاه و خلاصهسازی فیلمها را انجام دهد.
🔹 مدل Qwen 3.8-Omni-Flash برای ساخت ایجنتهای هوش مصنوعی چندوجهی طراحی شده و قادر به پردازش همزمان صدا و ویدیو است.
🔹 پنجره زمینه این مدل به یک میلیون توکن میرسد و Qwen عملکرد آن را در وظایف صوتی و ویدیویی نزدیک به Gemini 3.8 Flash اعلام کرده است.
🔹 هزینه API برابر با ۰٫۱۵ دلار بهازای هر یک میلیون توکن ورودی و ۰٫۴۷ دلار بهازای هر یک میلیون توکن خروجی است.
🔹 هزینه پردازش یک ساعت صوت کمتر از ۰٫۰۱ دلار و ویدیوی 720p همراه با صدا با نرخ یک فریمبرثانیه حدود ۰٫۲۰ دلار اعلام شده است.
🔹 ابزارهای Qwen-MM-Plugins و Qwen-Live Harness قابلیتهایی مانند ویرایش ویدیو و تعامل بلادرنگ با دوربین و میکروفون را به ایجنتها اضافه میکنند.
مدل Qwen 3.8-Omni-Flash برخلاف مدلهایی که صرفا ورودیهای چندرسانهای را تحلیل میکنند، برای پردازش محتوا، نتیجهگیری و استفاده مستقل از ابزارها طراحی شده است. این قابلیت به ایجنت اجازه میدهد پس از تحلیل صدا و تصویر، ابزار مناسب را برای انجام یک کار انتخاب و استفاده کند.
از نمونه کاربردهای مطرحشده برای این مدل میتوان به ویرایش ولاگ، ترجمه ویدیوهای کوتاه و تهیه خلاصه از فیلمها اشاره کرد. مدل میتواند اطلاعات صوتی و تصویری را در کنار یکدیگر پردازش کند و از ترکیب آنها برای انجام وظایف چندمرحلهای استفاده کند.
مدل Qwen 3.8-Omni-Flash از پنجره زمینه یک میلیون توکنی پشتیبانی میکند. چنین ظرفیت بالایی به مدل امکان میدهد حجم زیادی از اطلاعات را در یک زمینه واحد پردازش کند؛ قابلیتی که بهویژه هنگام کار با محتوای طولانی و چندرسانهای اهمیت پیدا میکند.
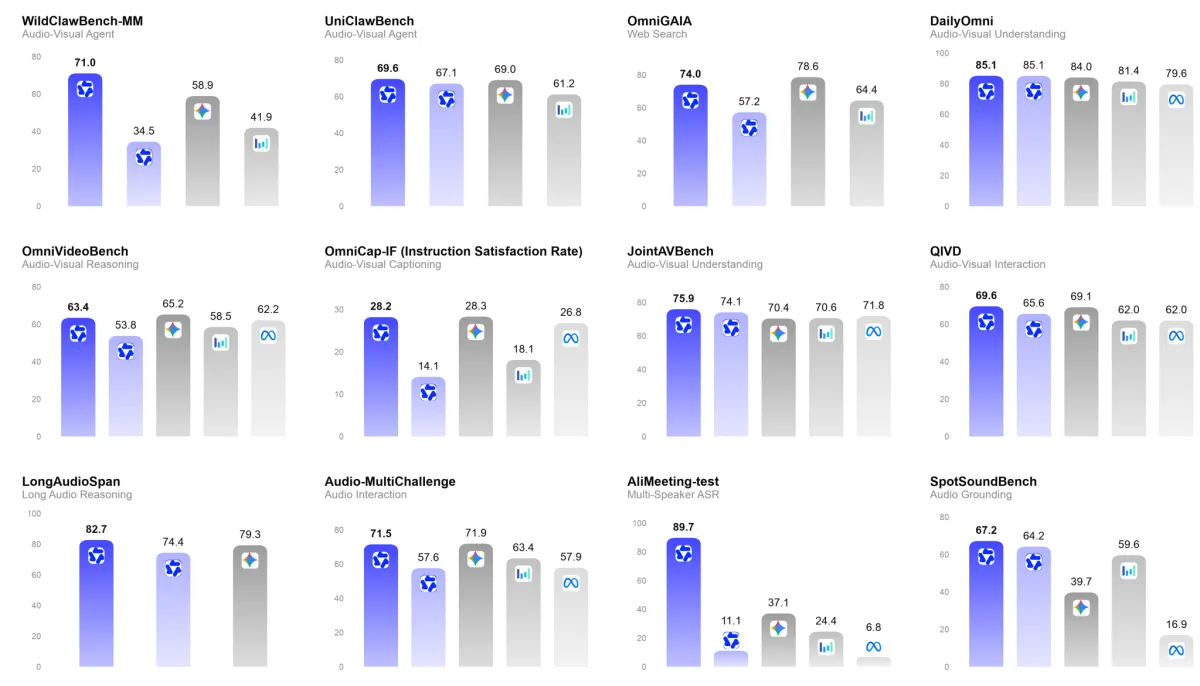
بر اساس اطلاعات منتشرشده از سوی Qwen، عملکرد این مدل در بنچمارکهای صوتی و ویدیویی به Gemini 3.8 Flash نزدیک است.
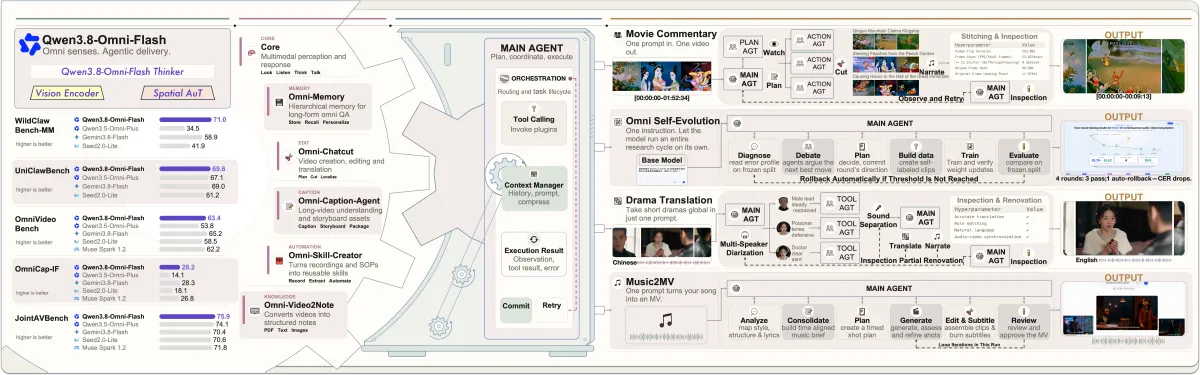
مدل هوش مصنوعی Qwen 3.8-Omni-Flash
یکی از نکات قابلتوجه Qwen 3.8-Omni-Flash قیمت استفاده از API آن است. هزینه پردازش ورودی ۰٫۱۵ دلار بهازای هر یک میلیون توکن و هزینه خروجی ۰٫۴۷ دلار بهازای هر یک میلیون توکن تعیین شده است.
| مدل | یک میلیون توکن ورودی | یک میلیون توکن خروجی |
|---|---|---|
| Qwen 3.8-Omni-Flash | ۰٫۱۵ دلار | ۰٫۴۷ دلار |
| Gemini 3.8 Flash | ۰٫۷۵ دلار | ۳٫۷۵ دلار |
قیمتهای ذکرشده برای Gemini 3.8 Flash نرخ اولیه این مدل هستند و طبق اطلاعات منبع، قرار است از ۱ ژانویه ۲۰۲۷ (۱۱ دی ۱۴۰۵) دو برابر شوند.
برآورد Qwen نشان میدهد پردازش ورودی صوتی برای هر ساعت کمتر از ۰٫۰۱ دلار هزینه دارد. پردازش یک ویدیوی 720p همراه با صدا و با نرخ نمونهبرداری یک فریمبرثانیه نیز حدود ۰٫۲۰ دلار هزینه خواهد داشت.
این ارقام تنها هزینه ورودی را در نظر میگیرند و هزینه تولید پاسخ مدل در آنها محاسبه نشده است.
مدل جدید از طریق Qwen Studio، سرویس Qwen Cloud و API در دسترس قرار گرفته است. توسعهدهندگان میتوانند بسته به نوع محصول یا گردشکار خود از رابطهای مختلف برای استفاده از قابلیتهای چندوجهی مدل بهره ببرند.
مجموعه متنباز Qwen-MM-Plugins قابلیتهای تکمیلی چندرسانهای را به ایجنتهای هوش مصنوعی اضافه میکند. این مجموعه برای استفاده در ابزارهایی مانند Claude Code، Gemini CLI و Qwen Code طراحی شده است.
قابلیتهای این افزونهها شامل ویرایش ویدیو، تشخیص گوینده، ساخت یادداشت ویدیویی از فایلهای PDF و ایجاد گردشکارهای قابل استفاده مجدد میشود. در نتیجه، توسعهدهندگان میتوانند وظایف چندمرحلهای مبتنی بر صدا، تصویر، ویدیو و اسناد را در ایجنتهای خود پیادهسازی کنند.
ابزار Qwen-Live Harness نیز برای ایجاد تعامل بلادرنگ در نظر گرفته شده است. این ابزار امکان استفاده همزمان از دوربین و میکروفون را فراهم میکند تا ایجنت بتواند اطلاعات صوتی و تصویری محیط را بهصورت زنده دریافت و پردازش کند.
مدل Qwen 3.8-Omni-Flash پردازش همزمان صوت و ویدیو، پنجره زمینه یک میلیون توکنی و قابلیت استفاده از ابزارها را برای ساخت ایجنتهای چندوجهی ترکیب میکند. قیمت پایین API و ارائه ابزارهای متنباز برای ویرایش ویدیو، تشخیص گوینده و تعامل زنده نیز بخش مهمی از مجموعه قابلیتهای ارائهشده در کنار این مدل است.
به نظر شما قیمت پایینتر Qwen 3.8-Omni-Flash میتواند توسعهدهندگان بیشتری را به ساخت ایجنتهای هوش مصنوعی صوتی و ویدیویی ترغیب کند؟