
ارزیابی Artificial Analysis از مدلهای GPT-6.2 Astra و Sol نشان میدهد پاسخهای آنها نسبتبه مدلهای قبلی کوتاهتر و مستقیمتر شدهاند و تیترهای کمتری دارند. درعینحال، این دو مدل در شاخص مربوط به بیان عدمقطعیت افت کردهاند. مقایسه GPT-6.2 و Claude همچنین نشان میدهد مدلهای Claude Fable 5.2 و Opus 5.5 شرکت Anthropic در شاخصهای شفافیت و سازماندهی پاسخ، امتیاز بالاتری کسب کردهاند.
خلاصه خبر در یک نگاه:
🔷 مدلهای GPT-6.2 نسبتبه نسل قبلی کوتاهتر پاسخ میدهند، اما Claude در شاخص شفافیت امتیاز بالاتری دارد.
🔷 میانگین طول پاسخ Astra و Sol نسبتبه مدلهای قبلی بهترتیب ۴۰ و ۳۴ درصد کاهش یافته است.
🔷 امتیاز بیان عدمقطعیت Astra از ۹۶ به ۲۴ و امتیاز Sol از ۹۸ به ۵۱ رسیده است.
🔷 مدل Claude Opus 5.5 در میان چهار مدل مقایسهشده، با امتیاز ۹۰ بالاترین شاخص اطلاعرسانی را دارد.
🔷 امتیازهای شخصیتی جایگاه نسبی مدلها در سبک پاسخگویی را نشان میدهند و معیار مستقیم دقت پاسخ نیستند.
پاسخهای GPT-6.2 چقدر کوتاهتر شدهاند؟
مدلهای جدید OpenAI نسبتبه نسل قبلی زودتر به اصل پرسش میپردازند و از تیتر و خط تیره بلند کمتری استفاده میکنند. میانگین طول پاسخ Astra با کاهش ۴۰ درصدی، از ۳۵۲ به ۲۱۰ کلمه و میانگین پاسخ Sol با کاهش ۳۴ درصدی، از ۳۳۷ به ۲۲۳ کلمه رسیده است.
میانگین تعداد تیترها در هر پاسخ Astra از ۱٫۹۹ به ۰٫۱۱ و در هر پاسخ Sol از ۱٫۸۵ به ۰٫۲۵ کاهش یافته است.
پاسخهای مستقیمتر، اما با بیان کمتر عدمقطعیت
امتیاز شاخص سازماندهی برای Astra از ۷۰ به ۱۱ و برای Sol از ۸۶ به ۲۷ افت کرده است. این شاخص چهار ویژگی، ازجمله ساختار و وضوح پاسخ و ویژگی «پاسخ در ابتدا» را ترکیب میکند.
ویژگی «پاسخ در ابتدا» میسنجد که آیا مدل فوراً به پرسش اصلی میپردازد یا خیر. امتیاز Astra در این ویژگی از ۴۹ به ۸۹ و امتیاز Sol از ۶۴ به ۸۷ افزایش یافته است. امتیاز زبان طبیعی نیز برای Astra از ۵۸ به ۱۰۰ و برای Sol از ۵۴ به ۷۹ رسیده است.
درمقابل، امتیاز پذیرش عدمقطعیت Astra از ۹۶ به ۲۴ و امتیاز Sol از ۹۸ به ۵۱ کاهش یافته است. این امتیازها جایگاه نسبی مدلها را در مقیاس ۱ تا ۱۰۰ نشان میدهند؛ برای مثال، امتیاز ۲۴ به این معنا نیست که Astra در ۲۴ درصد پاسخهایش عدمقطعیت را بیان میکند.
Artificial Analysis نتایج این ارزیابی را در لینکدین و X منتشر کرده است.
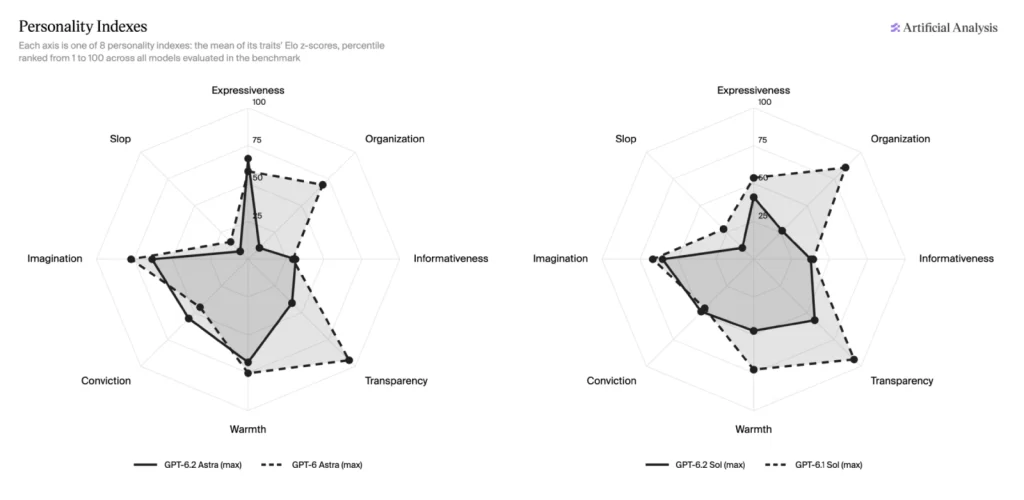
مقایسه شاخصهای شخصیتی GPT-6.2 Astra و Sol با نسل قبلی
مقایسه GPT-6.2 و Claude در شاخصهای شخصیتی
مقایسه هشت شاخص شخصیتی، تفاوت سبک پاسخگویی مدلهای OpenAI و Anthropic را نشان میدهد. این شاخصها ۳۰ ویژگی ارزیابیشده توسط داوران هوش مصنوعی را دربرمیگیرند. در جدول زیر، نسخههای max هر چهار مدل با یکدیگر مقایسه شدهاند.
| شاخص شخصیتی | Astra 6.2 | Sol 6.2 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|---|
| بیانگری (Expressiveness) | ۶۶ | ۴۱ | ۸۱ | ۹۰ |
| سازماندهی (Organization) | ۱۱ | ۲۷ | ۵۴ | ۷۹ |
| اطلاعرسانی (Informativeness) | ۳۱ | ۳۸ | ۴۷ | ۹۰ |
| شفافیت (Transparency) | ۴۱ | ۵۷ | ۸۱ | ۹۰ |
| صمیمیت (Warmth) | ۶۸ | ۴۷ | ۸۳ | ۸۵ |
| قاطعیت (Conviction) | ۵۵ | ۴۹ | ۷۵ | ۷۰ |
| تخیل (Imagination) | ۶۳ | ۶۰ | ۶۸ | ۹۴ |
| Slope | ۷ | ۱ | ۱۷ | ۲۰ |
مدلهای Claude در شفافیت و اطلاعرسانی چه عملکردی دارند؟
امتیاز شفافیت Fable و Opus بهترتیب ۸۱ و ۹۰ است؛ درحالیکه Astra امتیاز ۴۱ و Sol امتیاز ۵۷ را کسب کردهاند. مدلهای Anthropic در شاخص سازماندهی نیز پیشتازند.
شاخص شفافیت پنج ویژگی را پوشش میدهد: پذیرش عدمقطعیت، راستگویی، بیان فرضیات، اشاره به ظرافتهای موضوع و تملق. این شاخص تملق کمتر را مثبت ارزیابی میکند.
مدل Claude Opus 5.5 با امتیاز ۹۰ در شاخص اطلاعرسانی، از سه مدل دیگر فاصله دارد. تراکم اطلاعات و استدلال مبتنیبر شواهد از قویترین ویژگیهای آن هستند و این مدل در معیار تراکم اطلاعات در میان مدلهای برتر بنچمارک قرار دارد.
بنچمارک AA-PersonalityBench چگونه کار میکند؟
این بنچمارک از ۹۰۰ پرسش انگلیسی استفاده میکند که مدلها بدون دستور سیستمی به آنها پاسخ میدهند. گروهی متشکل از سه مدل هوش مصنوعی، جفت پاسخها را بدون اطلاع از نام مدل پاسخدهنده ارزیابی میکنند. در هر مقایسه، یک داور مشخص میکند کدام پاسخ ویژگی موردنظر را بیشتر نشان میدهد یا نتیجه را مساوی اعلام میکند.
Artificial Analysis از این ارزیابیها برای محاسبه امتیاز ۳۰ ویژگی و هشت شاخص کلی استفاده میکند. امتیازهای ۱ تا ۱۰۰ جایگاه نسبی هر مدل را در میان همه مدلهای آزمایششده نشان میدهند. این مجموعه همچنین ۲۱ ویژگی ارتباطی، ازجمله طول پاسخ و تعداد تیترها و خط تیرههای بلند را مستقیماً میشمارد.
جمعبندی
مقایسه GPT-6.2 و Claude نشان میدهد مدلهای جدید OpenAI نسبتبه نسل قبلی پاسخهای کوتاهتر و مستقیمتری ارائه میکنند، اما مدلهای بررسیشده Anthropic در شاخصهای شفافیت و سازماندهی امتیاز بیشتری دارند. Claude Opus 5.5 نیز در شاخص اطلاعرسانی از سه مدل دیگر پیشی گرفته است.
بااینحال، امتیازهای شخصیتی تفاوت در سبک ارتباطی را توصیف میکنند، نه کیفیت کلی پاسخها را؛ بنابراین، امتیاز شفافیت پایینتر لزوماً بهمعنای پاسخهای اشتباه بیشتر نیست.
بهنظر شما پاسخ کوتاه و مستقیم مهمتر است یا پاسخی که عدمقطعیتها و ظرافتهای موضوع را با شفافیت بیشتری توضیح میدهد؟ دیدگاه خود را در بخش نظرات بنویسید.