
انویدیا مدل هوش مصنوعی چندوجهی و باز Nemotron 3.5 Super VL را با ۱۲۰ میلیارد پارامتر معرفی کرده است؛ مدلی که برای ایجنتهای هوش مصنوعی سازمانی و پردازش مداوم متن، تصویر، اسناد و ویدئو طراحی شده است. در کنار آن، مدلهای کوچکتر خانواده Bolt نیز با هدف اجرای عاملهای هوش مصنوعی بهصورت محلی روی کامپیوترها و دستگاههای اج معرفی شدهاند.
🔷 مدل هوش مصنوعی انویدیا Nemotron 3.5 Super VL دارای ۱۲۰ میلیارد پارامتر است، اما در هر توکن تنها ۱۲ میلیارد پارامتر آن فعال میشوند.
🔷 انویدیا میگوید Super VL در وظایف ایجنتمحور میتواند با حدود یکپنجم پارامترها به دقت Nemotron 3 Ultra نزدیک شود.
🔷 مدل Nemotron 3.5 Bolt 74B-A9B 24GB برای اجرای محلی ارائه شده و تنها ۹ میلیارد پارامتر از مجموع ۷۴ میلیارد پارامتر آن در هر مرحله فعال هستند.
🔷 مدل Super VL قادر به تحلیل متن، تصویر، جدول، نمودار، PDF و ویدئو بدون نیاز به یک مدل بینایی جداگانه است.
🔷 انویدیا وزن مدلها، مجموعهدادهها، دستورالعملهای آموزش و محیطهای یادگیری تقویتی را نیز منتشر میکند.
مدل جدید انویدیا برای ایجنتهای تخصصی هوش مصنوعی طراحی شده است که میتوانند بهطور مداوم در پسزمینه فعالیت کرده و انواع مختلف داده شامل متن، تصویر، اسناد و ویدئو را پردازش کنند.
مدل Nemotron 3.5 Super VL از معماری Mixture-of-Experts یا MoE استفاده میکند. اگرچه این مدل در مجموع ۱۲۰ میلیارد پارامتر دارد، تنها ۱۲ میلیارد پارامتر به ازای پردازش هر توکن فعال میشوند؛ رویکردی که امکان کاهش نیاز محاسباتی را فراهم میکند.
انویدیا این مدل را با همکاری Nemotron Coalition توسعه داده است؛ گروهی که شرکتهایی مانند Mistral AI ،Thinking Machines Lab ،Perplexity و Black Forest Labs در آن حضور دارند.
مدل هوش مصنوعی انویدیا Nemotron 3.5 Super VL
انویدیا مدل Super VL را از Nemotron 3 Ultra، بزرگترین مدل استدلالی خود، تقطیر کرده است. این شرکت ادعا میکند Super VL در وظایفی مانند پیروی از دستورها، فراخوانی ابزارها، اجرای فرایندهای تجاری چندمرحلهای و تحلیل تصاویر میتواند با حدود یکپنجم پارامترها به دقت Ultra دست پیدا کند.
براساس نتایج ارائهشده توسط انویدیا، Super VL در آزمونهای ایجنتمحور Hermes و LangChain حتی امتیاز بیشتری از Ultra کسب کرده و در بنچمارکهای برنامهنویسی SWE-bench و Terminal-Bench نیز از نسل قبلی Nemotron 3 Super جلوتر قرار گرفته است.
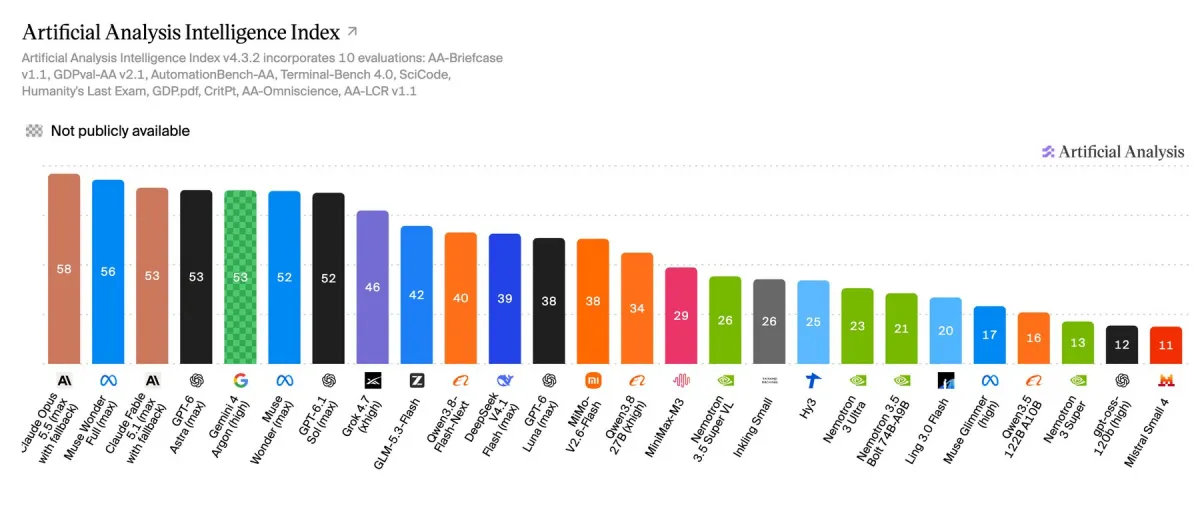
بااینحال، در رتبهبندی کلی Artificial Analysis، مدل Super VL همچنان با مدلهای بسته پیشرو فاصله قابلتوجهی دارد؛ هرچند عملکرد آن از Nemotron 3 Ultra خود انویدیا بالاتر گزارش شده است.
مدل هوش مصنوعی انویدیا Nemotron 3.5 Super VL
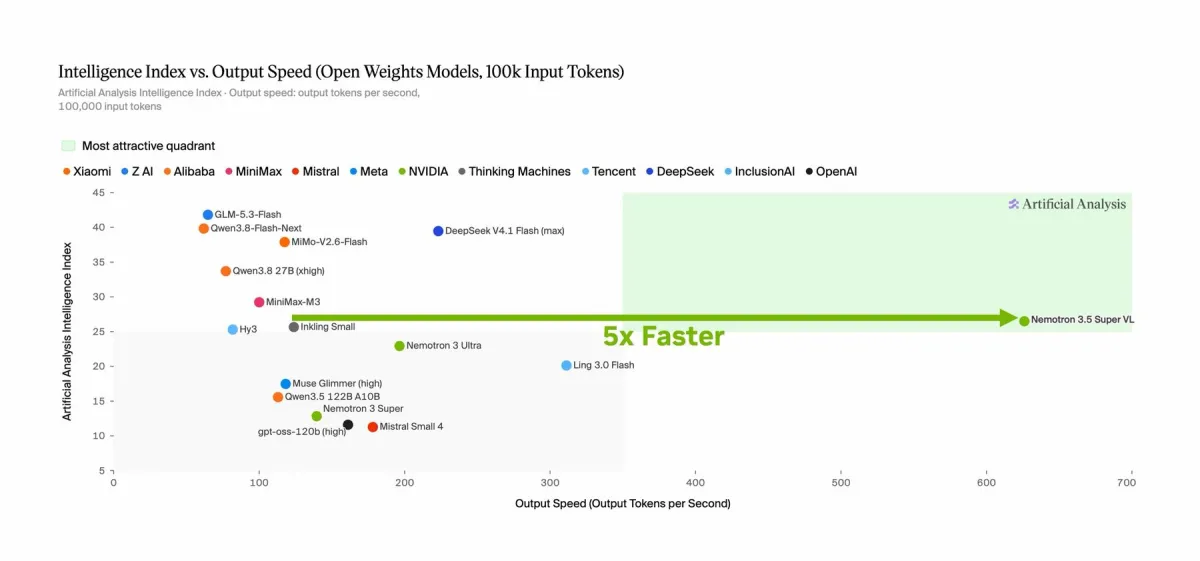
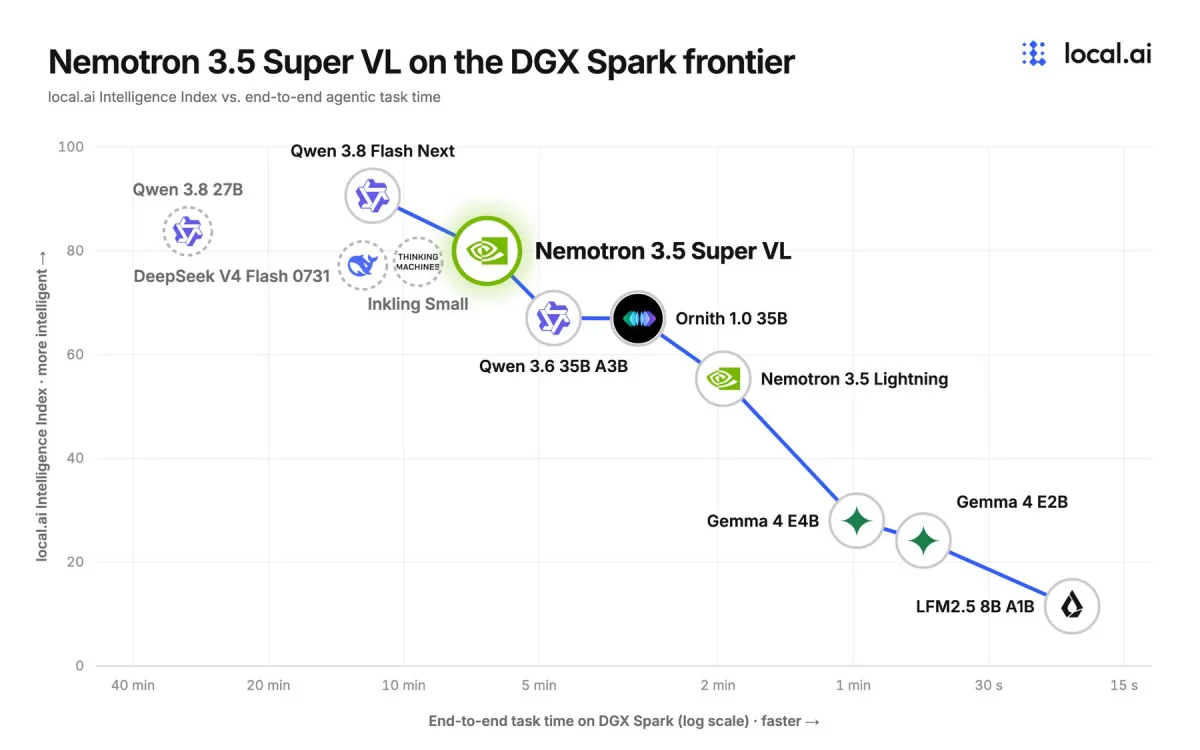
یکی از محورهای اصلی تمرکز انویدیا، افزایش سرعت اجرای وظایف ایجنتمحور است. این شرکت میگوید Super VL روی یک GPU میتواند در چنین وظایفی تا پنج برابر توان عملیاتی بیشتری نسبت به مدلهای باز هماندازه ارائه دهد.
در آزمایش مستقل EXO Labs روی DGX Spark نیز هیچیک از مدلهای آزمایششده نتوانستهاند بهطور همزمان از Super VL سریعتر و دقیقتر باشند. چنین مزیتی برای عاملهایی که باید طی چند روز یا چند هفته حجم زیادی از وظایف را انجام دهند، اهمیت بیشتری پیدا میکند.
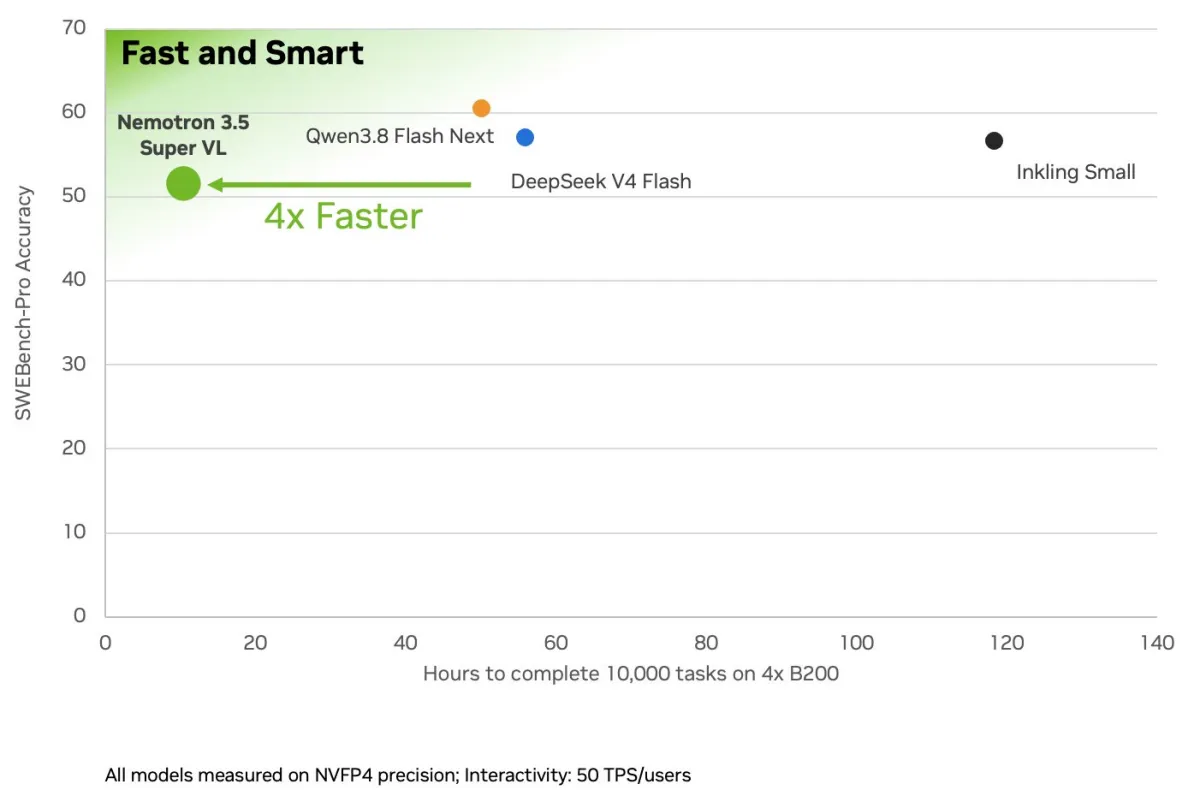
در یک مقایسه دیگر، Super VL در بنچمارک برنامهنویسی اندکی دقت کمتری نسبت به برخی رقبا داشت، اما طبق ادعای انویدیا وظایف را چهار برابر سریعتر تکمیل کرد.
انویدیا برای فشردهسازی Super VL از فرمت ۴ بیتی NVFP4 استفاده کرده است. روی پردازندههای گرافیکی Blackwell، کل مدل با دقت ۴ بیتی اجرا میشود، در حالی که کارتهای قدیمیتر وزنها را بهصورت ۴ بیتی ذخیره میکنند و محاسبات را با دقت ۱۶ بیتی انجام میدهند.
بخشهای حساس مدل نیز دقت بالاتری را حفظ میکنند. انویدیا برای جلوگیری از افت کیفیت، نسخه فشرده را بهگونهای آموزش داده است که خروجیهای نسخه اصلی و فشردهنشده را بازتولید کند.
مدل Super VL از یک بخش داخلی برای پیشبینی چند توکن آینده استفاده میکند و مدل اصلی میتواند این توکنها را در یک مرحله بررسی کند. انویدیا میگوید این روش میتواند سرعت تولید متن را تا ۲٫۳ برابر نسبت به حالتی که پیشنویس حدسی استفاده نمیشود، افزایش دهد.
این مدل همچنین محاسبات مربوط به بخشهای تکراری درخواستهای ایجنتهای هوش مصنوعی، مانند دستورها، توضیحات ابزارها و تاریخچه مکالمه را در حافظه کش نگه میدارد.
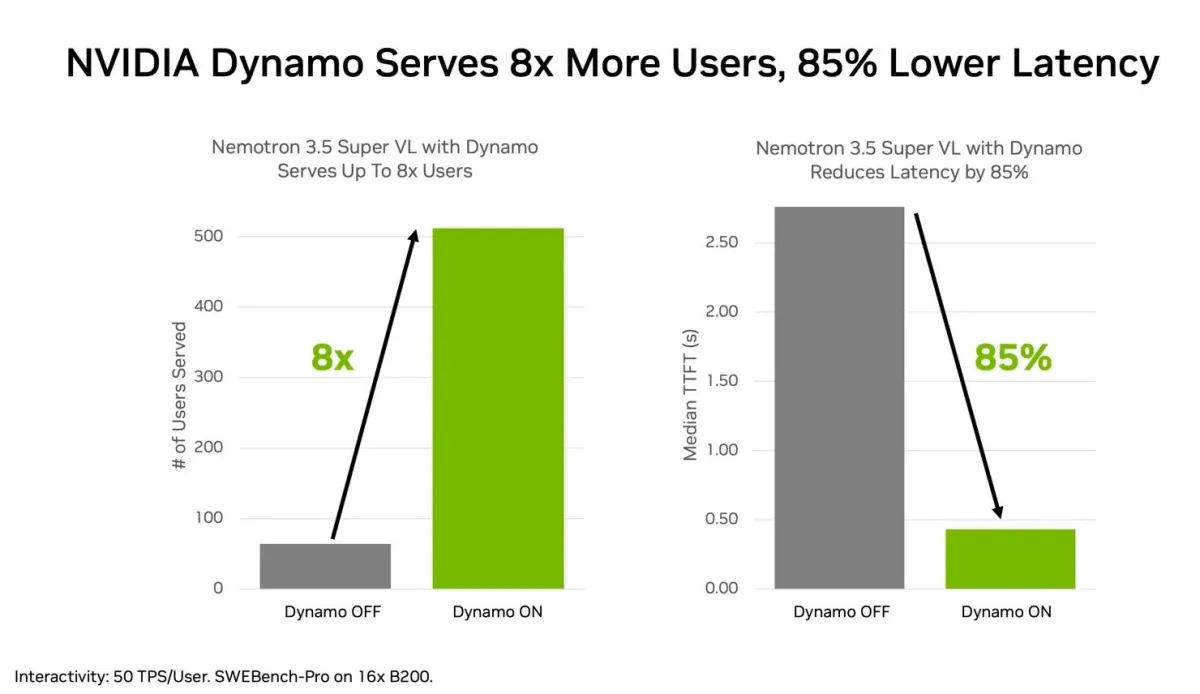
نرمافزار استنتاج Nvidia Dynamo نیز درخواستهای مربوط به یک نشست را به پردازنده گرافیکی هدایت میکند که اطلاعات کششده همان نشست را در اختیار دارد. طبق ادعای انویدیا، روی ۱۶ پردازنده گرافیکی B200 این روش امکان سرویسدهی به هشت برابر کاربر همزمان بیشتر را فراهم میکند و زمان رسیدن به نخستین توکن را ۸۵ درصد کاهش میدهد.
قابلیتهای چندوجهی Super VL با تمرکز بر دادههایی توسعه یافتهاند که ایجنتهای هوش مصنوعی در محیطهای کاری با آنها مواجه میشوند. این موارد شامل OCR، جدولها، نمودارها، اسناد چندصفحهای و ویدئو هستند.
برای مثال، مدل میتواند یک نمودار را تحلیل کند، ارتباط آن را با جدولی در بخش دیگری از همان سند تشخیص دهد و اطلاعات هر دو را بدون نیاز به یک مدل بینایی جداگانه خلاصه کند.
براساس نتایج انویدیا، Super VL در بنچمارک تحلیل نمودار CharXiv امتیاز ۸۰٫۸ درصد کسب کرده است؛ در حالی که Nemotron 3 Nano Omni امتیاز ۶۳ درصد داشت. با فراهم کردن امکان اجرای کد پایتون برای مدل، امتیاز Super VL به ۸۴ درصد افزایش پیدا میکند.
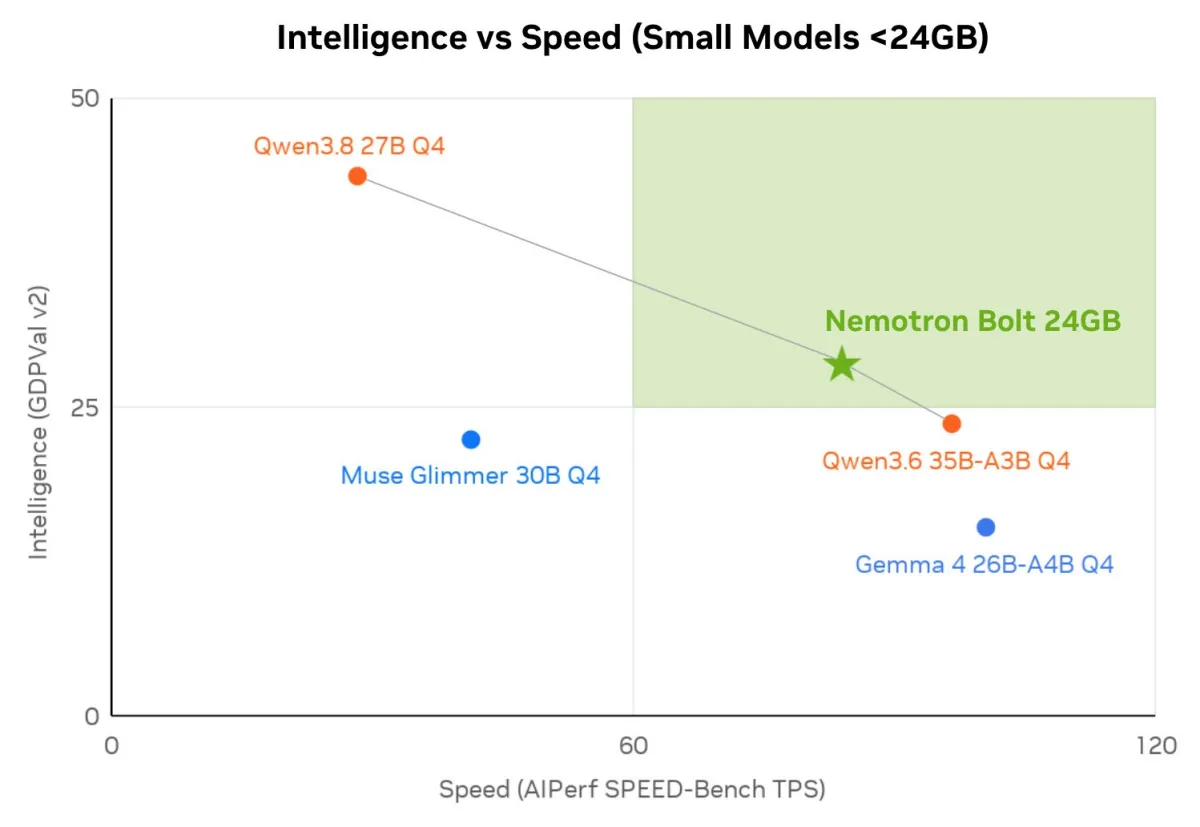
در کنار Super VL، انویدیا مدل Nemotron 3.5 Bolt 74B-A9B 24GB را برای اجرای وظایف ایجنتمحور روی سختافزار محلی معرفی کرده است.
این مدل نیز معماری ترکیبی Mixture-of-Experts دارد و از مجموع ۷۴ میلیارد پارامتر آن، تنها ۹ میلیارد پارامتر در هر مرحله فعال میشوند. انویدیا برای جای دادن مدل در ۲۴ گیگابایت حافظه، وزنهای آن را بهشکل گسترده با روش ۲ بیتی کوانتیزه کرده است.
Bolt برای کارهای روزمرهای طراحی شده است که در آن ایجنت هوش مصنوعی باید چند مرحله را پشت سر بگذارد، ابزار فراخوانی کند یا در وب جستوجو انجام دهد. انویدیا از نوشتن و اشکالزدایی کد و بررسی سازگاری قطعات کامپیوتر بهعنوان نمونههای کاربرد این مدل نام برده است.
مدل Bolt 74B-A9B 24GB برای RTX Spark و DGX Spark بهینه شده است و روی کامپیوترهای GeForce RTX، سیستمهای DGX Station و ورکاستیشنهای RTX PRO نیز اجرا میشود. این مدل از llama.cpp ،Ollama ،LM Studio و vLLM نیز پشتیبانی میکند.
با وجود فشردهسازی سنگین، نیاز به ۲۴ گیگابایت حافظه همچنان مانعی جدی برای استفاده گسترده کاربران عادی محسوب میشود. چنین ظرفیتی بیشتر در سختافزارهای ردهبالا و گرانقیمت در دسترس است و به همین دلیل، این مدل فعلاً بیشتر توسعهدهندگان و دارندگان ورکاستیشنهای قدرتمند را هدف قرار میدهد.
انویدیا برای سختافزارهای محدودتر، مدل Bolt E4B 4GB را نیز آماده کرده است که قرار است در ادامه همین ماه عرضه شود.
این مدل برای اجرا روی کارتهای GeForce RTX، ماژولهای Jetson و سیستمهای RTX/DGX Spark طراحی شده و کاربردهایی مانند دستیارهای صوتی، شخصیتهای تعاملی و رابطهای دستگاه را هدف قرار میدهد. انویدیا میگوید مدل میتواند در چند نوبت مکالمه از ابزارها استفاده کند و از اتفاقات برنامهای که کاربر در آن حضور دارد آگاه بماند.
به گفته انویدیا، دهها سازمان در حال تنظیم Super VL برای نیازهای اختصاصی خود هستند؛ بهخصوص در صنایعی که حجم زیادی از اسناد و اطلاعات حساس دارند.
شرکت Scale AI این مدل را برای ایجنتی که اعتبارات فروشندگان شرکت رسانهای Skydance را مدیریت میکند، تطبیق داده و انتظار دارد هزینه به یکچهلم و زمان پاسخگویی به یکپنجم کاهش پیدا کند. Ramp نیز از مدل برای تبدیل تصاویر رسیدها به دادههای ساختاریافته استفاده میکند و انتظار پاسخگویی ۱۰ برابر سریعتر را دارد. EY و Hebbia نیز از جمله کاربران این مدل هستند.
در حوزه امنیت سایبری نیز AI21 ،Dream و CrowdStrike از جمله شرکتهایی هستند که از Super VL برای کاربردهای امنیتی استفاده میکنند یا در حال ساخت ایجنتهایی براساس آن هستند. Salesforce ،R1 ،Perplexity ،Dassault Systèmes و Mercor نیز در میان استفادهکنندگان این مدل قرار دارند.
انویدیا تنها وزن مدل را منتشر نکرده است. Super VL در نسخه پایه، نسخه پس از آموزش و نسخه فشرده ۴ بیتی ارائه میشود و مجموعهدادهها، دستورالعملهای آموزش و محیطهای یادگیری تقویتی نیز در دسترس توسعهدهندگان قرار میگیرند.
این مدل طی مراحل پیشآموزش و ادامه پیشآموزش با بیش از ۲۵ تریلیون توکن آموزش دیده است. مراحل پسآموزش و یادگیری تقویتی نیز حدود چهار میلیون نمونه در نزدیک به ۱۰۰ محیط آموزشی باز را شامل شدهاند.
انویدیا چندین مجموعهداده را نیز در Hugging Face منتشر میکند که موضوعاتی مانند استفاده ایجنتها از ابزار، پیروی از دستورها، پردازش متنهای طولانی، درک تصاویر، امور مالی، ایمنی و انصاف را پوشش میدهند.
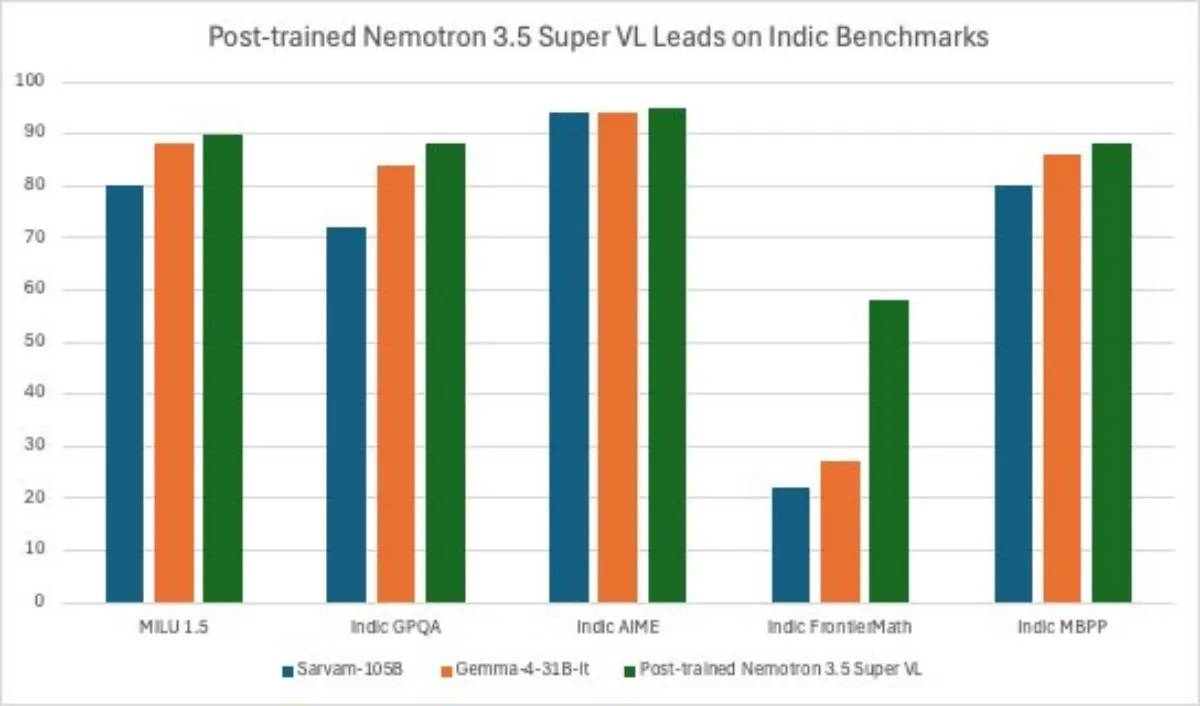
یکی از مجموعهدادههای جدید با همکاری مؤسسه فناوری هند در مدرس و آزمایشگاه AI4Bharat توسعه یافته است. این مجموعه شامل حدود ۲٫۸۳ تریلیون توکن متن در ۲۲ زبان هندی میشود.
نسخه تنظیمشده Super VL با استفاده از این دادهها در بنچمارکهای زبانهای هند از برخی مدلهای تخصصی بزرگتر مانند Sarvam-105B نیز عملکرد بهتری نشان داده است.
مدل Super VL روی سیستمهایی مانند DGX Spark ،DGX Station ،RTX PRO و RTX، ماژولهای Jetson و همچنین زیرساختهای دیتاسنتر و فضای ابری قابل اجرا است.
شرکتها همچنین میتوانند از طریق Nvidia NIM به این مدل در قالب یک میکروسرویس آماده استقرار با پیکربندیهای تأییدشده و پشتیبانی دسترسی داشته باشند. انویدیا برنامه دارد بهروزرسانیهای این سرویس را هر دو هفته یکبار ارائه کند و وزن مدلهای Super VL و Bolt نیز در Hugging Face در دسترس قرار گرفته است.
مدل Nemotron 3.5 Super VL تلاش انویدیا برای ارائه یک مدل چندوجهی باز و بهینهشده برای ایجنتهای هوش مصنوعی سازمانی است. این مدل با وجود داشتن ۱۲۰ میلیارد پارامتر، در هر توکن تنها ۱۲ میلیارد پارامتر را فعال میکند و برای تحلیل متن، تصاویر، اسناد، نمودارها و ویدئو طراحی شده است. در سوی دیگر، مدلهای Bolt اجرای محلی عاملهای هوش مصنوعی را هدف قرار میدهند، هرچند نسخه ۲۴ گیگابایتی همچنان به سختافزار ردهبالا نیاز دارد. انتشار وزنها در کنار مجموعهدادهها و دستورالعملهای آموزشی نیز بخش مهم دیگری از رویکرد انویدیا برای گسترش اکوسیستم Nemotron محسوب میشود.
به نظر شما مدلهای باز و قابل اجرای محلی مانند Nemotron میتوانند شرکتها را به اجرای هوش مصنوعی روی زیرساخت اختصاصی خود بهجای سرویسهای ابری ترغیب کنند؟