
متا با نسل جدید مدل هوش مصنوعی Muse Wonder و Muse Wonder Full پیشرفت قابلتوجهی در کدنویسی، ریاضیات و انجام مستقل وظایف پیچیده ثبت کرده است. مدل قدرتمندتر Muse Wonder Full در نسخه ۴.۳ شاخص Intelligence Index مؤسسه Artificial Analysis امتیاز ۵۶ را کسب کرده، اما دانش واقعیتمحور همچنان یکی از نقاط ضعف این خانواده محسوب میشود.
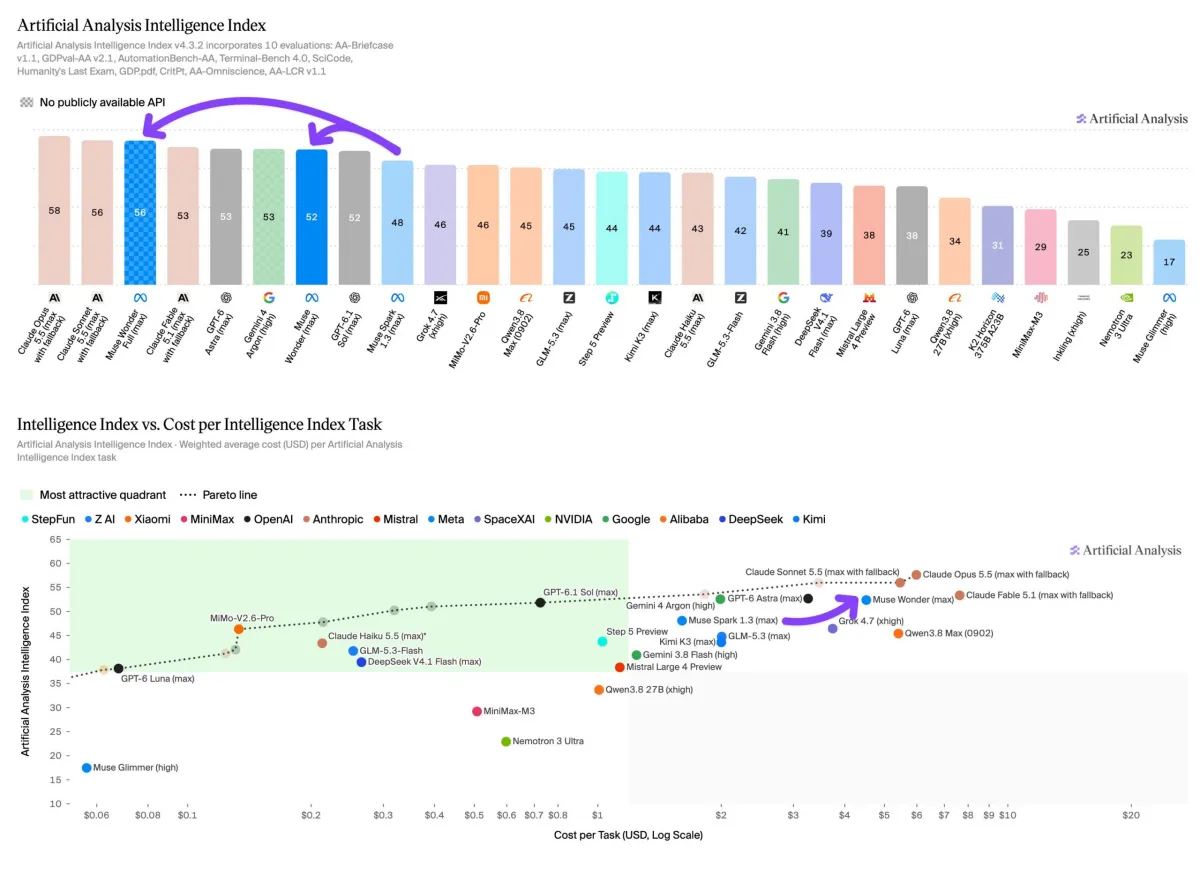
🔷 مدل جدید متا Muse Wonder Full در شاخص Intelligence Index امتیاز ۵۶ و Muse Wonder امتیاز ۵۲ را کسب کردهاند؛ نسل قبلی Muse Spark 1.3 امتیاز ۴۸ داشت.
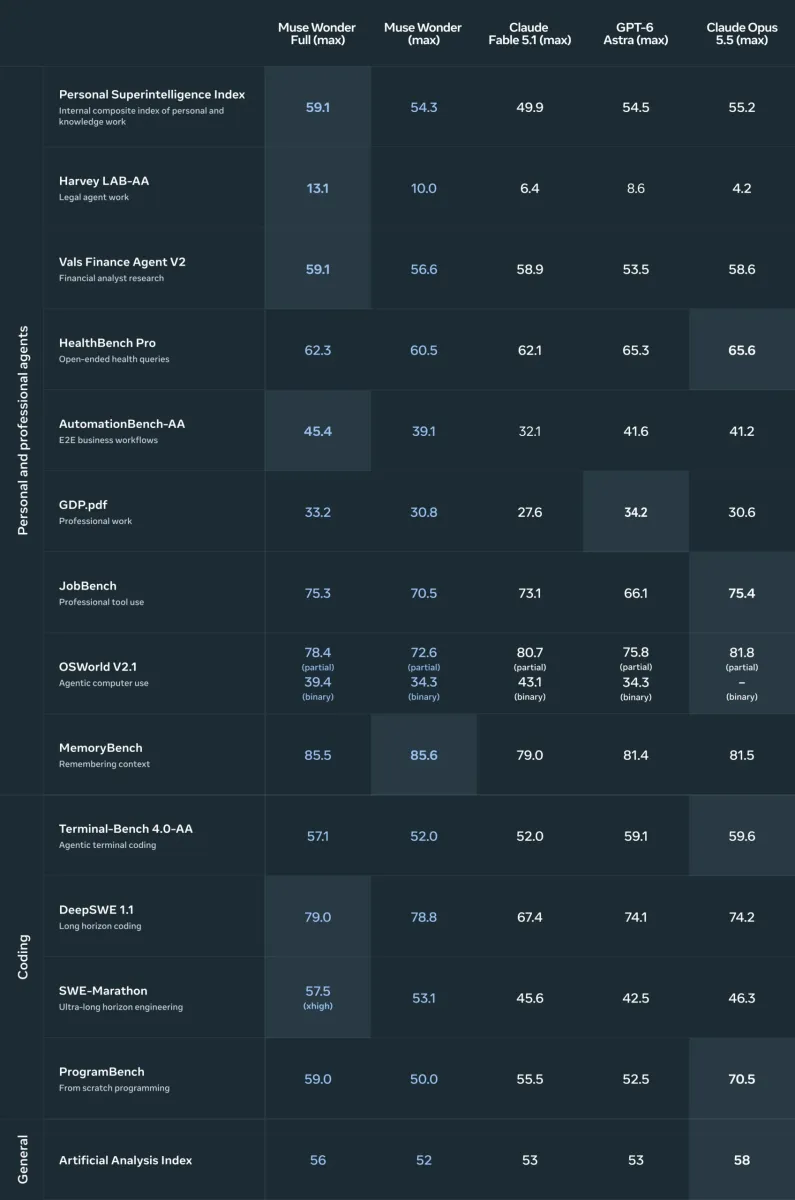
🔷 عملکرد Muse Wonder Full در آزمون Terminal-Bench 4.0 از ۳۳ به ۵۷ درصد رسیده و این مدل در ۶ مورد از ۱۰ بنچمارک در میان سه مدل برتر قرار گرفته است.
🔷 هر دو مدل از پنجره زمینه یک میلیون توکنی و ورودی متن، تصویر، ویدئو و صدا پشتیبانی میکنند.
🔷 کدنویسی و ریاضیات بیشترین پیشرفت را داشتهاند، اما عملکرد مدلها در آزمون دانش واقعیتمحور همچنان از برخی رقبا پایینتر است.
🔷 افزایش عملکرد با رشد هزینه همراه بوده و هزینه Muse Wonder در Intelligence Index به ۴٫۵۲ دلار برای هر وظیفه رسیده است.
مدل هوش مصنوعی متا Muse Wonder Full در نسخه ۴.۳ شاخص Artificial Analysis Intelligence Index امتیاز ۵۶ را ثبت کرده است و Muse Wonder نیز به امتیاز ۵۲ رسیده است. برای مقایسه، مدل قبلی Muse Spark 1.3 امتیاز ۴۸ داشت.
بخش مهمی از این پیشرفت در ارزیابیهای عاملمحور دیده میشود؛ آزمونهایی که توانایی مدل هوش مصنوعی برای انجام مستقل وظایف پیچیده را ارزیابی میکنند. در Terminal-Bench 4.0 عملکرد از ۳۳ به ۵۷ درصد افزایش یافته است.
مدل Muse Wonder Full در مجموع در ۶ مورد از ۱۰ بنچمارک مورد بررسی، در میان سه مدل برتر قرار گرفته است؛ نتیجهای که نشاندهنده بهبود عملکرد مدلهای جدید متا پس از دوره ضعیفتر مدلهای متنباز Llama است.
مدل هوش مصنوعی پرچمدار متا Muse Wonder
متا دو قابلیت جدید را در مدلهای خود برجسته کرده است. قابلیت Active Memory به مدل اجازه میدهد اطلاعات مهم را بین مکالمات به خاطر بسپارد و هنگام نیاز دوباره از آنها استفاده کند.
قابلیت Active Focus نیز برای ادامه دادن وظایف دشوار طراحی شده است. مدل میتواند روشهای جایگزین را امتحان کند و در صورت نامشخص بودن بخشی از درخواست، سؤالهای تکمیلی بپرسد.
این دو ویژگی بخش مهمی از برنامه متا برای توسعه یک عامل هوش مصنوعی شخصی هستند که بتواند به تقویم، پیامها و اسناد کاربر دسترسی داشته باشد.
هر دو مدل Muse Wonder و Muse Wonder Full از پنجره زمینه یک میلیون توکنی پشتیبانی میکنند و قادر به دریافت متن، تصویر، ویدئو و صدا بهعنوان ورودی هستند.
مدل Muse Wonder از طریق API متا و Muse Code در دسترس قرار گرفته است، درحالیکه دسترسی به Muse Wonder Full فعلاً به کاربران Muse Code محدود میشود.
متا همچنین قصد دارد بهزودی از Muse Wonder برای قدرتبخشیدن به اپلیکیشن Muse استفاده کند. دسترسی در ابتدا برای مشترکان پولی فراهم خواهد شد و این شرکت در ادامه قصد دارد مدلهای تخصصی مبتنی بر آن را برای همه کاربران توسعه دهد.
کدنویسی یکی از حوزههایی است که نسل جدید مدلهای متا در آن پیشرفت زیادی نشان میدهد. Muse Wonder Full در Coding Agents Index امتیاز ۶۸ را کسب کرده و از این نظر با Claude Code مبتنی بر Sonnet 5.5 برابر شده است.
مدل Muse Wonder نیز در همین شاخص به امتیاز ۶۳ رسیده است؛ درحالیکه مدل نسل قبل امتیاز ۵۴ را ثبت کرده بود.
با وجود پیشرفت در کدنویسی و وظایف عاملمحور، دانش واقعیتمحور همچنان یکی از نقاط ضعف این خانواده است. در آزمون AA-Omniscience، مدل Muse Wonder Full تنها امتیاز ۳۰ و Muse Wonder امتیاز ۲۵ را کسب کردهاند.
این نتایج پایینتر از Claude Opus 5.5 با امتیاز ۴۶، GPT-6 Astra با امتیاز ۴۳ و Gemini 4 Argon با امتیاز ۴۲ هستند. براساس تحلیل منبع، این اختلاف میتواند نشان دهد خانواده Wonder بر پایه مدل پایه کوچکتری نسبت به برخی رقبا ساخته شده است.
در مقابل، کاهش نرخ توهم تا حدی این ضعف را جبران میکند. نرخ توهم Muse Wonder Full در مقایسه با نسل قبل از ۳۳ به ۲۳ درصد کاهش یافته است. در میان مدلهایی که حداقل ۴۵ امتیاز در شاخص کسب کردهاند، این دومین نرخ پایین محسوب میشود و تنها Gemini 4 Argon با نرخ ۱۵ درصد نتیجه بهتری دارد.
متا در توضیحات خود به یکی از انتقادهای رایج درباره مدلهای Muse نیز پرداخته است؛ اینکه این مدلها برای کسب نتایج بالا در بنچمارکها بهینه شدهاند، اما در کاربردهای واقعی عملکرد مشابهی ندارند.
این شرکت میگوید Muse Wonder Full در وظایف ناآشنایی که بخشی از فرایند بهینهسازی آموزشی نبودهاند نیز عملکردی بهتر از انتظار دارد و این موضوع را به مدل پایه قدرتمندتر نسبت میدهد.
در شاخص Vals AI نیز نسخه Muse Wonder Full (Max) کار خود را از رتبه پنجم آغاز کرده و طبق اعلام Vals AI، بالاتر از تمام مدلهای OpenAI قرار گرفته است. تنها مدلهای فعلی Anthropic امتیاز بیشتری کسب کردهاند. Muse Wonder نیز در جایگاه دهم قرار دارد.
ریاضیات در کنار کدنویسی یکی دیگر از حوزههای اصلی پیشرفت نسل Wonder است. در ProofBench که یک بنچمارک خصوصی برای ارزیابی اثباتهای ریاضی محسوب میشود، Muse Wonder Full توانسته است ۹۴ مسئله از مجموع ۱۰۰ مسئله را حل کند.
نسل قبلی در همین آزمون تنها ۵۸ مسئله را حل کرده بود. نتیجه جدید Muse Wonder Full تنها ۵ تا ۶ امتیاز با مدلهای پیشرو که امتیازهای ۹۹ تا ۱۰۰ دارند فاصله دارد.
عملکرد Muse Wonder Full در Terminal-Bench 4 نیز دو برابر شده است، درحالیکه مدل برای دستیابی به این نتیجه ۳۰ درصد توکن خروجی کمتری مصرف کرده است. در مقابل، عملکرد در وظایف مالی و حقوقی تقریباً در سطح نسل قبل باقی مانده و در برخی موارد تا دو امتیاز کاهش داشته است.
بهبود تواناییهای Muse Wonder هزینه استفاده از این مدل را نیز افزایش داده است. طبق دادههای Artificial Analysis، هزینه اجرای هر وظیفه در Intelligence Index برای Muse Wonder به ۴٫۵۲ دلار میرسد؛ تقریباً سه برابر هزینه ۱٫۶۰ دلاری Muse Spark 1.3.
قیمت پردازش هر یک میلیون توکن ورودی نیز از ۱٫۲۵ دلار در نسل قبلی به ۴ دلار افزایش یافته و هزینه یک میلیون توکن خروجی از ۴٫۲۵ دلار به ۲۰ دلار رسیده است.
مدل Muse Wonder برای هر وظیفه ۲۸ درصد توکن ورودی بیشتری نسبت به نسل قبلی مصرف میکند و توکنهای ورودی ۷۶ درصد از کل هزینه را تشکیل میدهند.
| مدل | هزینه هر وظیفه در Intelligence Index |
|---|---|
| Claude Fable 5.1 | ۷٫۶۳ دلار |
| Claude Opus 5.5 | ۵٫۹۸ دلار |
| Muse Wonder | ۴٫۵۲ دلار |
| GPT-6 Astra | ۳٫۲۶ دلار |
| Gemini 4 Argon | ۱٫۹۹ دلار |
| GPT-6.1 Sol | ۰٫۷۲ دلار |
در حال حاضر اطلاعاتی درباره قیمتگذاری توکنی Muse Wonder Full منتشر نشده است. هر دو مدل جدید در مقایسه با نسل قبلی حدود ۱۰ درصد توکن خروجی کمتری مصرف میکنند.
متا اعلام کرده است مدلهای جدید خود را در دیتاسنتر اختصاصی Prometheus و در مقیاس گیگاواتی آموزش داده است.
نتایج بنچمارکها نشان میدهند Muse Wonder Full بهخصوص در کدنویسی، ریاضیات و وظایف عاملمحور پیشرفت قابلتوجهی داشته است، هرچند دانش واقعیتمحور و افزایش هزینه استفاده همچنان از محدودیتهای این نسل به شمار میروند.
مدلهای Muse Wonder و Muse Wonder Full نسبت به Muse Spark 1.3 پیشرفت محسوسی در کدنویسی، ریاضیات و انجام وظایف پیچیده نشان میدهند و نرخ توهم نیز در مدل قدرتمندتر کاهش یافته است. در مقابل، عملکرد ضعیفتر در آزمون دانش واقعیتمحور و افزایش قابلتوجه هزینه استفاده، از مهمترین نقاط ضعف نسل جدید مدلهای هوش مصنوعی متا هستند.
بهنظر شما در انتخاب یک مدل هوش مصنوعی، عملکرد بهتر در کدنویسی و وظایف عاملمحور اهمیت بیشتری دارد یا دانش واقعیتمحور و هزینه پایینتر؟