
گوگل مدل متنباز جدید EmbeddingGemma 2 را معرفی کرده است؛ مدلی با ۷۴۰ میلیون پارامتر که میتواند متن، تصویر، ویدیو، صدا و کد را به بردارهای عددی تبدیل کند تا جستوجو و مقایسه محتوای مشابه آسانتر شود. گوگل این مدل را جمعوجورترین مدل در نوع خود معرفی میکند و میگوید عملکرد آن در بنچمارکهای امبدینگ چندوجهی از برخی مدلهای رقیب با دو برابر اندازه نیز بهتر است.
🔹 مدل EmbeddingGemma 2 گوگل با ۷۴۰ میلیون پارامتر از متن، تصویر، ویدیو، صدا و کد پشتیبانی میکند.
🔹 مدل جدید بهصورت محلی و بدون نیاز به کلید API اجرا میشود و تنها حدود ۱۹۱ مگابایت رم نیاز دارد.
🔹 پردازش هر درخواست از طریق WebGPU در مرورگر حدود ۲۰ تا ۷۰ میلیثانیه زمان میبرد.
🔹 امتیاز مدل در بخش کدنویسی Massive Text Embedding Benchmark از ۶۸.۷۶ به ۷۸.۶۸ رسیده است.
🔹 ترکیب EmbeddingGemma 2 با مدلهایی مانند Gemma 4 امکان ساخت برنامههای RAG کاملاً آفلاین را فراهم میکند.
مدل EmbeddingGemma 2 گوگل برای تبدیل انواع محتوا به بردارهای عددی یا Embedding طراحی شده است. این بردارها نمایش عددی محتوای ورودی هستند و به نرمافزارها اجازه میدهند میزان شباهت میان دادههای مختلف را محاسبه کنند.
نسخه جدید محدود به متن نیست و میتواند متن، تصویر، ویدیو، صدا و کد را پردازش کند. چنین قابلیتی برای کاربردهایی مانند جستوجوی معنایی، بازیابی اطلاعات و سیستمهای RAG اهمیت دارد.
گوگل میگوید EmbeddingGemma 2 با وجود برخورداری از تنها ۷۴۰ میلیون پارامتر، جمعوجورترین مدل در کلاس خود محسوب میشود و در بنچمارکهای امبدینگ چندوجهی از مدلهای رقیبی با حداکثر دو برابر اندازه نیز عملکرد بهتری دارد.
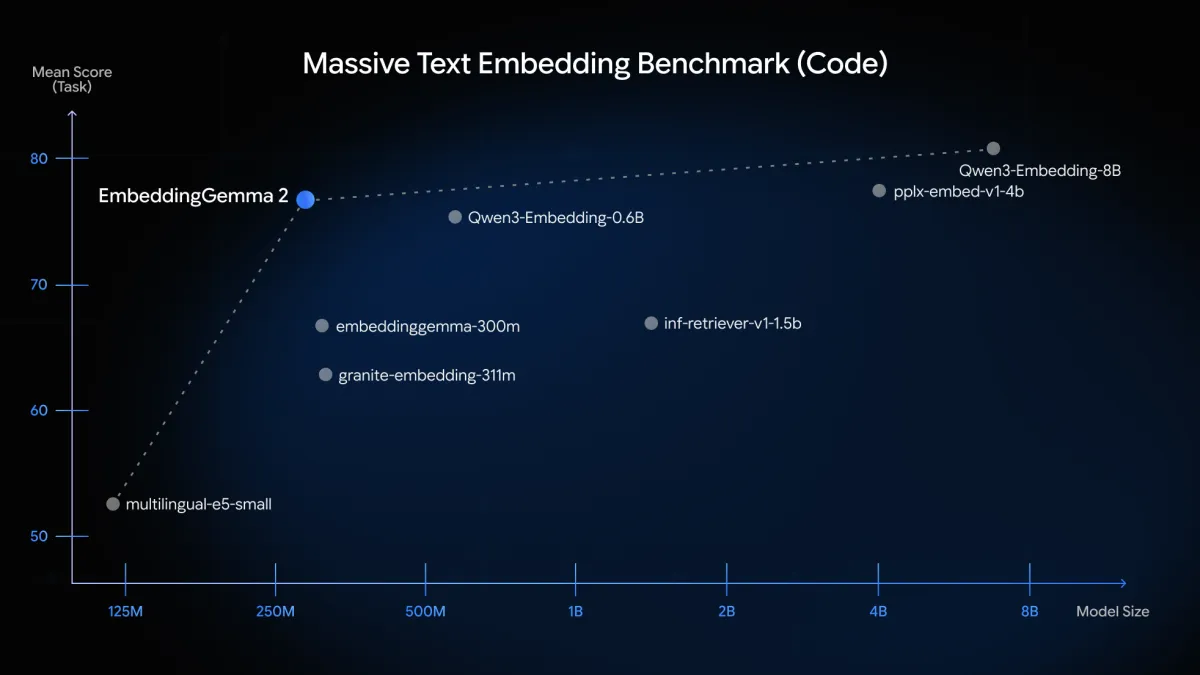
یکی از پیشرفتهای قابل توجه نسل جدید در بنچمارک Massive Text Embedding Benchmark و بخش کدنویسی دیده میشود.
مدل EmbeddingGemma 2 در این آزمون امتیاز ۷۸.۶۸ را ثبت کرده است، در حالی که نسل قبلی امتیاز ۶۸.۷۶ را به دست آورده بود. بنابراین عملکرد مدل جدید تقریباً ۱۰ امتیاز افزایش پیدا کرده و به سطح برخی مدلهای بسیار بزرگتر رسیده است.
| مدل | امتیاز MTEB در بخش کد |
|---|---|
| EmbeddingGemma 2 | ۷۸.۶۸ |
| نسل قبلی EmbeddingGemma | ۶۸.۷۶ |
مدل EmbeddingGemma 2 گوگل
یکی از ویژگیهای مهم EmbeddingGemma 2 امکان اجرای کاملاً محلی و بدون نیاز به کلید API است. این قابلیت امکان استفاده از مدل را بدون وابستگی دائمی به سرویسهای ابری فراهم میکند.
براساس اطلاعات ارائهشده، مدل برای اجرا تنها به حدود ۱۹۱ مگابایت حافظه رم نیاز دارد. پردازش هر درخواست نیز هنگام استفاده از WebGPU در مرورگر تقریباً ۲۰ تا ۷۰ میلیثانیه زمان میبرد.
مدل جدید همچنین میتواند فضای مورد نیاز برای ذخیره پایگاه داده برداری محلی را تا ۶ برابر کاهش دهد. این موضوع بهویژه برای برنامههایی که حجم بالایی از دادههای امبدینگ را روی دستگاه نگهداری میکنند اهمیت دارد.
کاربرانی که تنها با محتوای متنی سروکار دارند، الزاماً به نسخه ۷۴۰ میلیون پارامتری نیاز ندارند. برای وظایف صرفاً متنی، نسخهای با ۲۷۰ میلیون پارامتر نیز در دسترس است.
این گزینه کوچکتر میتواند برای برنامههایی مناسب باشد که به قابلیتهای چندوجهی مانند پردازش تصویر، ویدیو یا صدا نیازی ندارند و اولویت آنها مصرف کمتر منابع سختافزاری است.
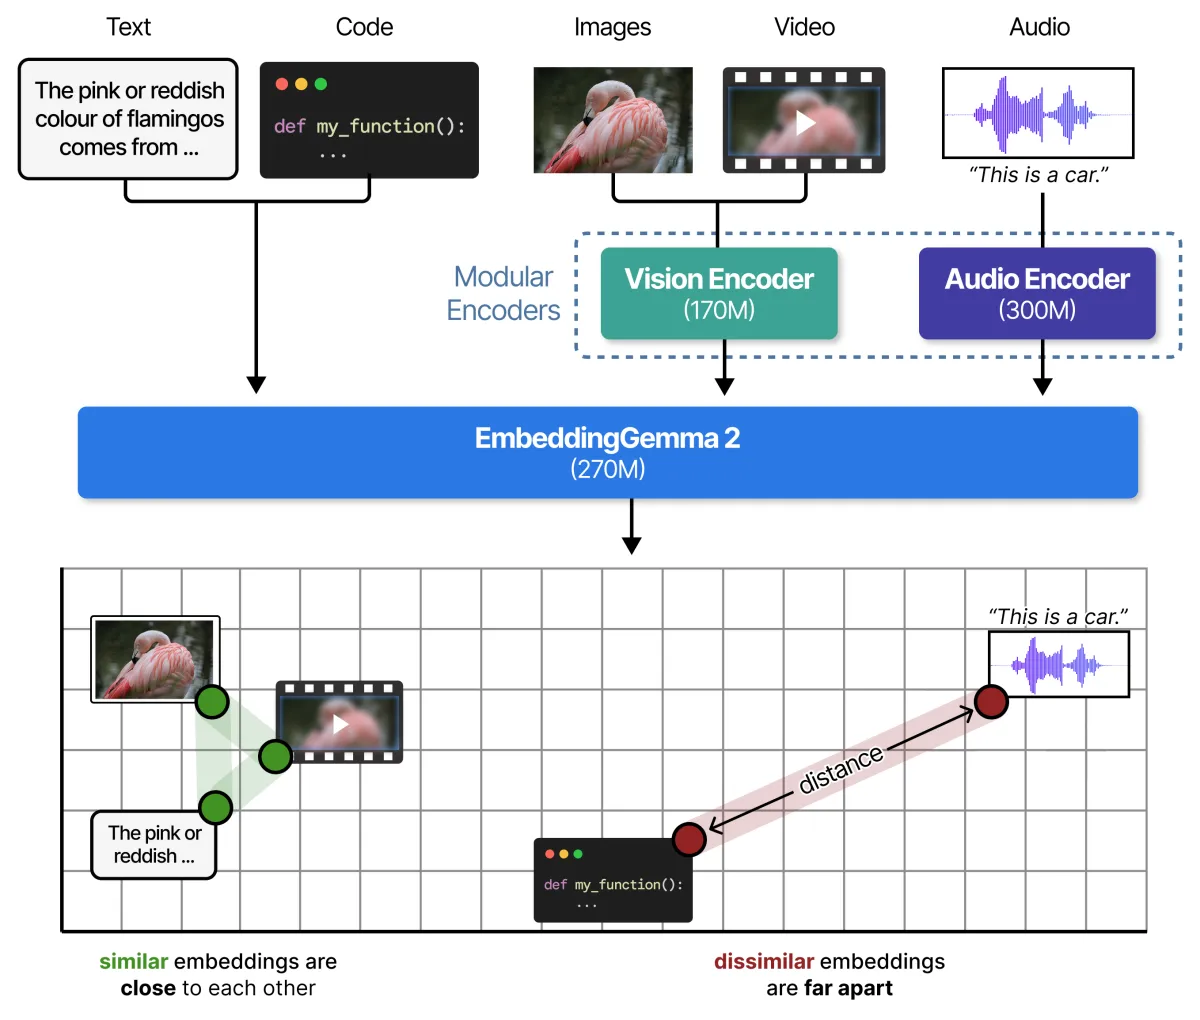
گوگل امکان ترکیب EmbeddingGemma 2 با مدلهای متنباز کوچک دیگری مانند Gemma 4 را نیز مطرح کرده است. چنین ترکیبی میتواند برای اجرای برنامههای مبتنی بر RAG بهصورت کاملاً محلی استفاده شود.
در این حالت، EmbeddingGemma 2 وظیفه تبدیل دادهها و درخواستهای کاربر به بردارهای عددی را برعهده میگیرد و مدل زبانی میتواند براساس اطلاعات بازیابیشده پاسخ تولید کند.
مهمتر اینکه این فرایند میتواند بدون ارسال اطلاعات به سرورهای خارجی انجام شود. بنابراین امکان ساخت برنامههای RAG آفلاین روی دستگاه فراهم میشود.
وزنهای EmbeddingGemma 2 بهصورت آزاد در Hugging Face و Kaggle منتشر شدهاند. گوگل همچنین راهنمای توسعهدهندگان و مستندات فنی این مدل را برای استفاده و پیادهسازی آن ارائه کرده است.
ترکیب اندازه نسبتاً کوچک، پشتیبانی از چند نوع محتوا و اجرای محلی باعث میشود مدل جدید برای توسعهدهندگانی که به جستوجوی معنایی و سیستمهای بازیابی اطلاعات بدون وابستگی به APIهای ابری نیاز دارند، گزینه قابل توجهی باشد.
EmbeddingGemma 2 مدل متنباز ۷۴۰ میلیون پارامتری گوگل برای تبدیل متن، تصویر، ویدیو، صدا و کد به بردارهای عددی است. این مدل با حدود ۱۹۱ مگابایت رم بهصورت محلی اجرا میشود، زمان پردازش آن در مرورگر با WebGPU بین ۲۰ تا ۷۰ میلیثانیه اعلام شده و میتواند فضای ذخیرهسازی پایگاه داده برداری را تا ۶ برابر کاهش دهد. نسخه ۲۷۰ میلیون پارامتری نیز برای کاربردهای صرفاً متنی در دسترس است.
به نظر شما امکان اجرای آفلاین مدلهایی مانند EmbeddingGemma 2 تا چه اندازه میتواند توسعه برنامههای هوش مصنوعی بدون وابستگی به سرویسهای ابری را گسترش دهد؟