
شرکت OpenAI برای رعایت الزامات اتحادیه اروپا، فناوری جدیدی به نام textGrain را برای افزودن واترمارک نامرئی به متنهای تولیدشده با ChatGPT معرفی کرده است. این فناوری با ایجاد یک الگوی آماری نامرئی در انتخاب واژههای مدل کار میکند و قرار است طی هفتههای آینده برای کاربران ChatGPT و Codex در اتحادیه اروپا فعال شود؛ با این حال، استفاده از آن برای مشتریان API در سراسر جهان اختیاری خواهد بود.
🔹 فناوری textGrain یک سیگنال آماری نامرئی را در انتخاب واژههای متن تولیدشده توسط مدلهای OpenAI قرار میدهد.
🔹 واترمارک طی هفتههای آینده برای کاربران ChatGPT و Codex در اتحادیه اروپا فعال خواهد شد، اما برای مشتریان API در سراسر جهان اختیاری است.
🔹 نرخ تشخیص به طول و موضوع متن وابسته است و ویرایش حتی بخش کوچکی از متن میتواند دقت تشخیص را بهشدت کاهش دهد.
🔹 جایگزینی ۲۵ درصد واژهها در یک متن ۴۰۰ توکنی، نرخ تشخیص گزارششده را به حدود ۱۷ درصد کاهش داده است.
🔹 دسترسی به ابزار تشخیص textGrain در ابتدا به پژوهشگران منتخب و سازمانهای تخصصی محدود خواهد بود.
براساس گزارش منتشرشده، قانون هوش مصنوعی اتحادیه اروپا ارائهدهندگان سیستمهای هوش مصنوعی را ملزم میکند متن تولیدشده را در قالبی قابل تشخیص توسط ماشین علامتگذاری کنند. پاسخ OpenAI به این الزام، فناوری textGrain است.
این سیستم بهجای قرار دادن علامتی قابل مشاهده در متن، یک سیگنال آماری نامرئی در نحوه انتخاب واژهها ایجاد میکند. در نتیجه، متن برای خواننده عادی تفاوت ظاهری مشخصی ندارد، اما ابزار تشخیص میتواند الگوی آماری ایجادشده توسط مدل را بررسی کند.
این روش از نظر ایده کلی به فناوری SynthID مورد استفاده برای واترمارک متنهای Claude شباهت دارد؛ فناوری متنبازی که توسط گوگل توسعه یافته است.
شرکت OpenAI اعلام کرده است که طی هفتههای آینده قابلیت واترمارک برای کاربران ChatGPT و Codex در اتحادیه اروپا فعال خواهد شد.
رویکرد این شرکت برای API متفاوت است. استفاده از واترمارک در APIهای OpenAI در سراسر جهان اختیاری خواهد بود و مشتریان میتوانند آن را فعال کنند. این قابلیت قرار است طی هفتههای آینده از طریق شرکای ابری مانند Microsoft Azure نیز ارائه شود.
این سیاست با رویکرد Anthropic تفاوت دارد؛ براساس گزارش منبع، واترمارک Claude بهصورت جهانی و مستقل از شیوه دسترسی کاربران به مدل اعمال میشود.
واترمارک ChatGPT
آزمایشهای داخلی OpenAI نشان میدهند عملکرد textGrain با طول و موضوع متن ارتباط مستقیمی دارد. این شرکت میگوید فناوری جدید در آزمایشهای داخلی با روشهای دیگر، از جمله SynthID گوگل برای متن، برابری کرده یا عملکرد بهتری داشته است.
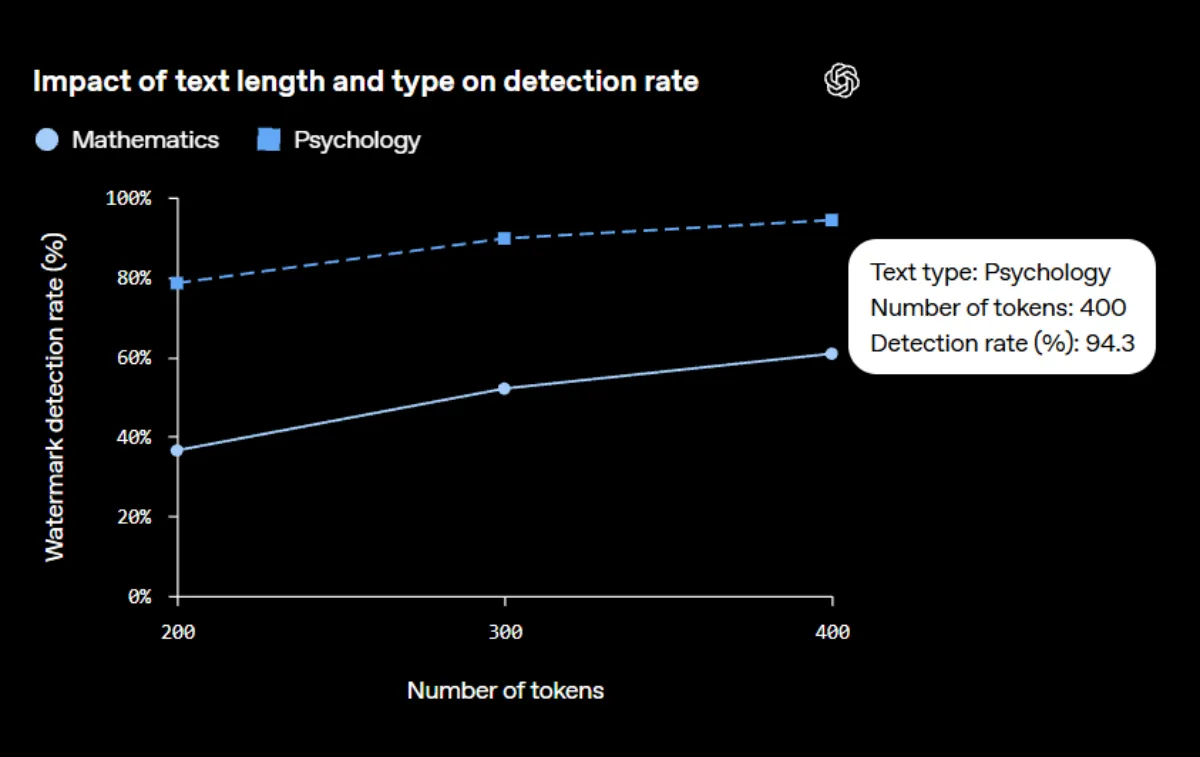
در آزمایشی که نرخ مثبت کاذب هدف روی یک درصد تنظیم شده بود، ابزار تشخیص توانست واترمارک حدود ۹۵ درصد از متنهای ۴۰۰ توکنی درباره روانشناسی را شناسایی کند. با کاهش طول متن به ۲۰۰ توکن، نرخ تشخیص به حدود ۸۰ درصد رسید.
در داده دیگری که برای متنهای حدود ۴۰۰ توکنی ارائه شده، نرخ تشخیص برای محتوای روانشناسی حدود ۹۴ درصد و برای محتوای ریاضی تنها حدود ۶۰ درصد بوده است.
به گفته OpenAI، عملکرد تشخیص در محتوای ریاضی بهطور محسوسی پایینتر است؛ زیرا مدل هنگام تولید چنین متنهایی آزادی کمتری برای انتخاب میان واژههای مختلف دارد.
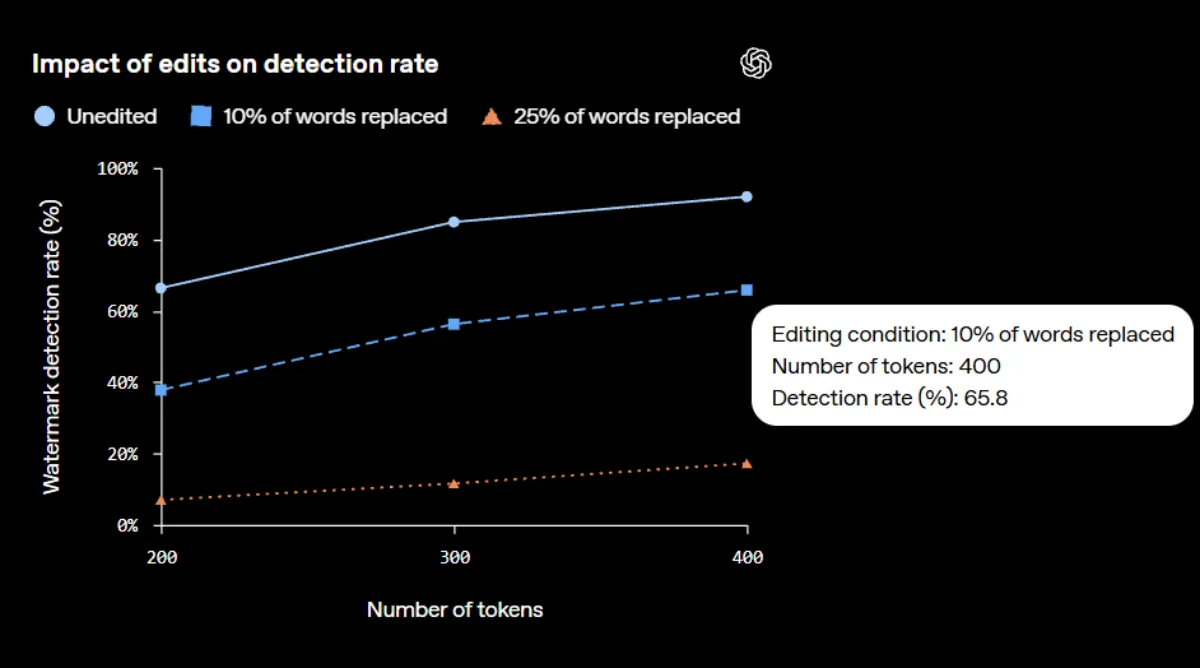
یکی از مهمترین محدودیتهای textGrain، کاهش سریع نرخ تشخیص پس از ویرایش متن است. آزمایشهای OpenAI نشان میدهند حتی تغییر نسبتاً محدود واژهها میتواند سیگنال آماری واترمارک را تضعیف کند.
| میزان تغییر متن ۴۰۰ توکنی | نرخ تقریبی تشخیص واترمارک |
|---|---|
| بدون جایگزینی گزارششده | حدود ۹۲ درصد |
| جایگزینی ۱۰ درصد واژهها با مترادف | حدود ۶۶ درصد |
| جایگزینی ۲۵ درصد واژهها | حدود ۱۷ درصد |
بنابراین جایگزینی تنها ۱۰ درصد واژهها با مترادفها میتواند نرخ تشخیص را از حدود ۹۲ به ۶۶ درصد کاهش دهد. با تغییر یکچهارم واژهها نیز این رقم به حدود ۱۷ درصد میرسد.
شرکت OpenAI تأکید کرده است که شناسایی واترمارک بهتنهایی مشخص نمیکند چه میزان خلاقیت یا ویرایش انسانی در تولید نسخه نهایی متن نقش داشته است.
وجود واترمارک همچنین مالکیت متن را اثبات نمیکند، مسئولیت آن را به فرد خاصی نسبت نمیدهد، هویت کاربر را مشخص نمیکند و نشاندهنده درست بودن محتوای متن نیست.
از سوی دیگر، شناسایی نشدن واترمارک نیز ثابت نمیکند که متن توسط انسان نوشته شده است. کوتاه بودن متن، ویرایش یا ترجمه آن و همچنین تولید محتوا توسط مدلی که ابزار تشخیص از آن پشتیبانی نمیکند، میتوانند از دلایل شناسایی نشدن واترمارک باشند.
شرکت OpenAI میگوید استفاده از واترمارک باعث افت کیفیت خروجی نمیشود. این شرکت برای پشتیبانی از این ادعا به آزمایشهای انجامشده روی مدل پرچمدار Astra اشاره کرده است.
براساس نتایج اعلامشده، فعال یا غیرفعال بودن واترمارک در هشت بنچمارک از جمله GPQA Diamond ،BrowseComp و DeepSWE تفاوت عملکرد معناداری ایجاد نکرده است.
با این حال، این آزمایشها مشخص نمیکنند که واترمارک چه تأثیری بر کیفیت نگارش متن دارد؛ موضوعی که درباره واترمارک Claude نیز مورد پرسش منتقدان قرار گرفته است.
شرکت OpenAI قصد دارد فناوری textGrain را بهصورت متنباز منتشر کند تا توسعهدهندگان و پژوهشگران دیگر نیز بتوانند بر پایه آن ابزارها و فناوریهای جدیدی توسعه دهند.
با این حال، دسترسی به ابزار تشخیص واترمارک در ابتدا عمومی نخواهد بود. تنها پژوهشگران منتخب و سازمانهای تخصصی میتوانند برای دریافت دسترسی درخواست ارسال کنند و OpenAI درخواستها را بهصورت موردی و در چارچوب دستورالعمل اتحادیه اروپا بررسی خواهد کرد.
ابزار تشخیص textGrain فقط اعلام خواهد کرد که آیا واترمارک OpenAI در متن مورد بررسی شناسایی شده است یا خیر. این ابزار هویت کاربران را مشخص نمیکند و اطلاعات مربوط به پرامپتها یا مکالمات آنها را نیز نمایش نمیدهد.
دلیل محدود کردن دسترسی اولیه به این ابزار، احتمال خطا در تشخیص عنوان شده است. آشکارساز ممکن است گاهی متن بدون واترمارک را علامتگذاری کند یا نتواند یک واترمارک واقعی را تشخیص دهد. OpenAI اعلام کرده زمانی دسترسی را گسترش خواهد داد که نتایج بتوانند بهشکل مسئولانه تفسیر شوند، اما زمان مشخصی برای این مرحله ارائه نکرده است.
ابزارهای موجود OpenAI برای اعتبارسنجی محتوای تصویری و صوتی همچنان بهصورت عمومی در دسترس خواهند بود.
فناوری textGrain راهکار OpenAI برای افزودن یک سیگنال آماری نامرئی به متنهای تولیدشده توسط مدلهای هوش مصنوعی است و قرار است برای ChatGPT و Codex در اتحادیه اروپا فعال شود. آزمایشهای ارائهشده نشان میدهند این فناوری روی متنهای بلندتر و برخی موضوعات عملکرد مناسبی دارد، اما ویرایش متن میتواند نرخ تشخیص را بهشدت کاهش دهد. برخلاف کاربران ChatGPT در اتحادیه اروپا، مشتریان API در سراسر جهان امکان انتخاب برای استفاده از این قابلیت را خواهند داشت.
به نظر شما واترمارک نامرئی میتواند راهکار مؤثری برای تشخیص متنهای تولیدشده با هوش مصنوعی باشد یا آسیبپذیری آن در برابر ویرایش، کاربردش را محدود میکند؟