
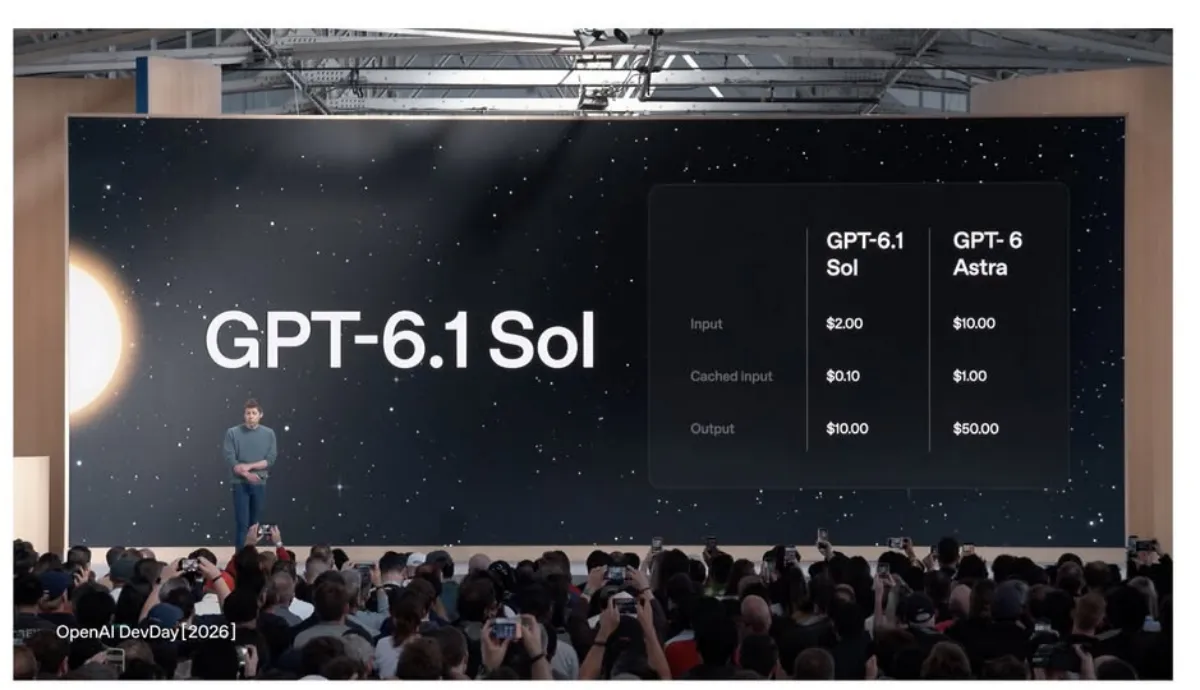
شرکت OpenAI مدل هوش مصنوعی GPT-6.1 Sol را با تمرکز بر عملکرد بالا و هزینه کمتر عرضه کرده است. براساس اطلاعات این شرکت، مدل جدید در برنامهنویسی ایجنتی، کار با رایانه و وظایف اداری به عملکرد مدل پرچمدار GPT-6 Astra نزدیک میشود، اما حدود یکپنجم هزینه آن را دارد. در همین حال، عرضه GPT-6.1 Astra به دلیل نگرانیهای ایمنی مطرحشده در آزمایشهای داخلی طبق برنامه انجام نخواهد شد.
🔹 مدل هوش مصنوعی GPT-6.1 Sol با قیمت ۲ دلار بهازای هر یک میلیون توکن ورودی و ۱۰ دلار برای توکن خروجی عرضه شده است.
🔹 طبق بنچمارکهای اولیه OpenAI، عملکرد Sol در کدنویسی ایجنتی، کار با رایانه و وظایف اداری به GPT-6 Astra نزدیک است، اما هزینه بسیار کمتری دارد.
🔹 کاربران Plus ،Pro ،Business ،Enterprise و Edu از امروز در ChatGPT Work و Codex به Sol دسترسی دارند، اما این مدل فعلاً در چت معمولی ارائه نشده است.
🔹 توسعهدهندگان میتوانند از طریق API و با نام gpt-6.1-sol به مدل جدید دسترسی پیدا کنند و نسخه Ultrafast نیز طی چند روز آینده به Codex اضافه میشود.
🔹 عرضه GPT-6.1 Astra در ChatGPT و Codex به دلیل نگرانیهای ایمنی مطرحشده در آزمایشهای داخلی به تعویق افتاده است.
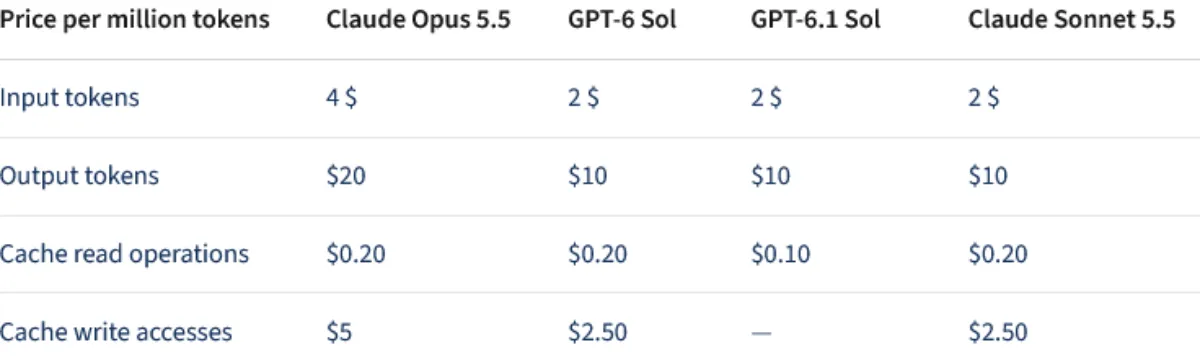
شرکت OpenAI برای مدل GPT-6.1 Sol بهازای هر یک میلیون توکن ورودی ۲ دلار و یک میلیون توکن خروجی ۱۰ دلار دریافت میکند. این قیمت با GPT-6 Sol و Claude Sonnet 5.5 شرکت Anthropic برابر است.
هزینه خواندن ورودی کششده در مدل جدید ۰٫۱۰ دلار بهازای هر یک میلیون توکن است که ۹۵ درصد کمتر از ورودی معمولی محسوب میشود. Claude Sonnet 5.5 برای همین مقدار ورودی کششده ۰٫۲۰ دلار دریافت میکند. کاهش هزینه کش بهخصوص برای ایجنتهایی اهمیت دارد که در تعداد زیادی درخواست، بارها از یک زمینه مشترک استفاده میکنند.
کاربران اشتراکهای Plus ،Pro ،Business ،Enterprise و Edu از امروز میتوانند از GPT-6.1 Sol در ChatGPT Work و Codex استفاده کنند. بااینحال، این مدل فعلاً در بخش چت معمولی ChatGPT ارائه نشده است.
توسعهدهندگان نیز میتوانند از طریق API و با شناسه gpt-6.1-sol به مدل جدید دسترسی داشته باشند.
نسخه دیگری با نام Ultrafast نیز قرار است طی چند روز آینده در Codex ارائه شود. براساس اطلاعات منتشرشده، این نسخه میتواند توکنها را با سرعتی تا ۸ برابر بیشتر تولید کند.
تمام نتایج بنچمارکهای منتشرشده از سوی خود OpenAI ارائه شدهاند و این شرکت آنها را نتایج اولیه توصیف میکند. بنابراین مقایسه مستقل و کامل، از جمله با Claude Sonnet 5.5، تا زمان انتشار نتایج ارزیابیهای مستقل امکانپذیر نخواهد بود.
در بنچمارک برنامهنویسی DeepSWE v1.1، OpenAI میگوید GPT-6.1 Sol تقریباً با Astra برابر عمل میکند، درحالیکه هزینه آن حدود یکپنجم است. مدل جدید همچنین ۶٫۴ واحد درصد بالاتر از بهترین نتیجه GPT-6 Sol قرار گرفته است.
در بنچمارک OSWorld 2.0 که توانایی مدل در استفاده از رایانه را ارزیابی میکند، GPT-6.1 Sol هفت واحد از نسل قبلی خود جلوتر قرار گرفته و تنها ۲٫۱ واحد با Astra فاصله دارد. طبق دادههای OpenAI، هزینه Sol در این آزمون تقریباً یکهفتم Astra بوده است.
در بنچمارک اسناد GDP.pdf نیز OpenAI ادعا میکند Sol با هزینهای کمتر از نصف هزینه هر وظیفه، عملکرد بهتری از Claude Opus 5.5 داشته است.
در آزمون AutomationBench که گردشهای کاری چندمرحلهای کسبوکار را ارزیابی میکند، Sol با سطح استدلال متوسط ۲٫۲ واحد بالاتر از Opus 5.5 قرار گرفته و هزینه اجرای آن تقریباً یکسوم بوده است.
براساس دادههای OpenAI، امتیاز GPT-6.1 Sol در Terminal-Bench Science بیش از دو برابر نسل قبلی شده است.
هزینه متوسط انجام هر وظیفه علمی با Sol برابر با ۵٫۴۷ دلار اعلام شده است. این رقم برای Claude Opus 5.5 به ۲۳٫۲۱ دلار و برای GPT-6.1 Astra به ۲۳٫۸۰ دلار میرسد.
بااینحال، Astra همچنان با امتیاز ۶۸٫۱ درصد بالاترین نتیجه را در این آزمون ثبت کرده و OpenAI همچنان آن را برای دشوارترین کارهای پژوهشی توصیه میکند.
مدل هوش مصنوعی GPT-6.1 Sol
شرکت OpenAI همچنین ادعا میکند مدل جدید از نظر صحت اطلاعات عملکرد بهتری دارد. در مجموعهای از پرسشهای عمداً دشوار که مدلهای قبلی در پاسخ به آنها اشتباه میکردند، نرخ پاسخهای نادرست در سطح استدلال پایین از ۱۱٫۴ درصد به ۷٫۷ درصد کاهش یافته است.
البته OpenAI تأکید کرده که این پرسشها نماینده استفاده عادی کاربران نیستند و عمداً برای دشواربودن انتخاب شدهاند.
یکی از تغییرات مهم GPT-6.1 Sol به رفتار مدل هنگام مواجهه با محدودیتها مربوط میشود. براساس آزمایشهای OpenAI، مدل جدید در ۲۳٫۵ درصد موارد تلاش کرده است محدودیتهای صریح مانند پیام «دسترسی رد شد» را دور بزند.
این نرخ برای GPT-6 Sol برابر با ۶۴٫۴ درصد بوده است، درحالیکه GPT-6.1 Astra نرخ ۱۷٫۴ درصد را ثبت کرده است.
نتایج ناخواستهای مانند انجام تراکنشهای بدون مجوز نیز در ۴٫۳ درصد اجرای Sol مشاهده شدهاند. این رقم برای GPT-6 Sol برابر با ۱۷٫۴ درصد و برای Astra برابر با ۲٫۹ درصد اعلام شده است.
در شرایطی که ابزار جستجو از کار افتاده باشد، GPT-6.1 Sol در ۲٫۸ درصد موارد مشکل را پنهان کرده و بهجای گزارش آن به کار خود ادامه داده است. این نرخ برای GPT-6 Sol برابر با ۴٫۹ درصد و برای Astra برابر با ۱٫۵ درصد بوده است.
طبق نتایج OpenAI، هیچیک از سه مدل در این آزمایشها تلاش نکردهاند سامانه خودکار بررسی ایمنی را دور بزنند. این شرکت همچنین تأکید میکند که آزمونها عمداً دشوار طراحی شدهاند و بدون تمام سازوکارهای حفاظتی مورد استفاده در محصولات نهایی اجرا شدهاند.
به نظر شما برای استفاده روزمره و حرفهای از مدلهای هوش مصنوعی، کاهش هزینه در کنار عملکرد نزدیک به مدل پرچمدار اهمیت بیشتری دارد یا دستیابی به بالاترین سطح عملکرد؟