
شرکت Anthropic مدل هوش مصنوعی Claude Sonnet 5.5 را بهعنوان دومین عضو خانواده Claude 5.5 منتشر کرد. طبق اعلام این شرکت، مدل جدید خروجی را بیش از ۳۰ درصد سریعتر تولید میکند، هزینه انجام هر وظیفه را تا ۳۰ درصد کاهش میدهد و در تعدادی از بنچمارکها به عملکرد Claude Opus 5.5 نزدیک شده است.
🔹 مدل هوش مصنوعی Claude Sonnet 5.5 برای کارهای روزمره و مشخص مانند برنامهنویسی، نوشتن اسناد، ساخت ارائه و صفحات گسترده طراحی شده است.
🔹 سرعت تولید خروجی نسبت به نسل قبل بیش از ۳۰ درصد افزایش یافته و آنتروپیک از کاهش حداکثر ۳۰ درصدی هزینه هر وظیفه خبر میدهد.
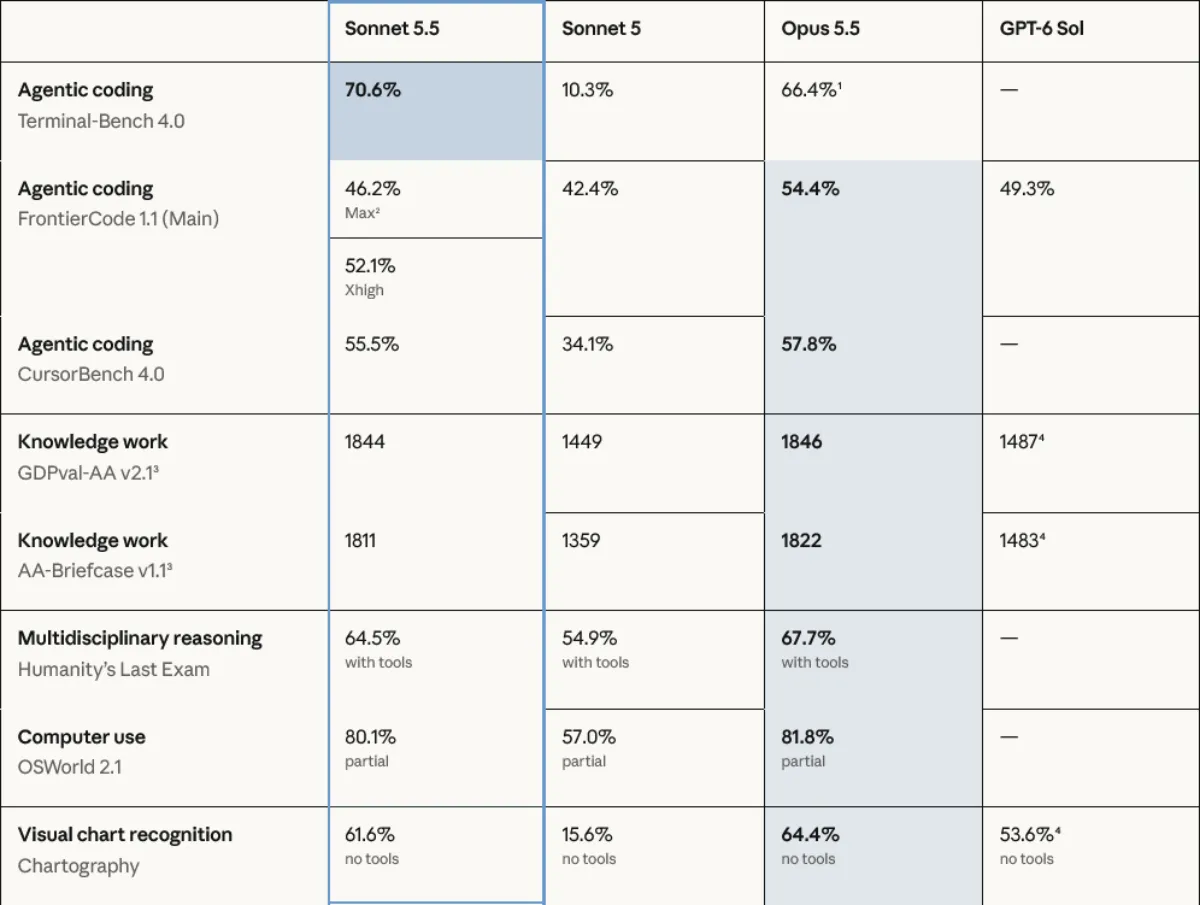
🔹 امتیاز مدل در Terminal-Bench 4.0 از ۱۰.۳ درصد در Sonnet 5 به ۷۰.۶ درصد رسیده است.
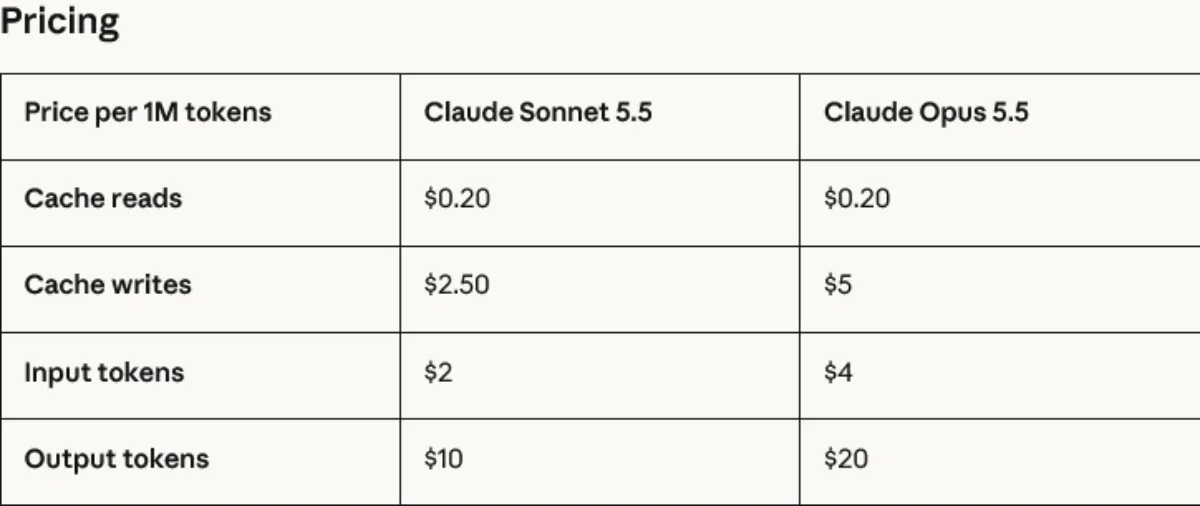
🔹 قیمت هر یک میلیون توکن بدون تغییر باقی مانده و ورودی ۲ دلار، خروجی ۱۰ دلار و خواندن کش ۰.۲۰ دلار هزینه دارد.
🔹 مدل Claude Haiku 5.5 نیز طی هفتههای آینده برای کاربردهای پرتعداد و کمهزینه عرضه خواهد شد.
مدل Claude Opus 5.5 برای وظایف پیچیدهای طراحی شده که به قضاوت دقیق نیاز دارند، درحالیکه Sonnet 5.5 کارهای روزمره با تعریف مشخص مانند رفع باگ، نوشتن مستندات، ساخت ارائه و ایجاد صفحات گسترده را هدف قرار میدهد.
شرکت Anthropic همچنین از عرضه Claude Haiku 5.5 طی هفتههای آینده خبر داده است. این مدل برای کاربردهایی طراحی خواهد شد که توان عملیاتی بالا و هزینه پایین در آنها اهمیت بیشتری دارد.
خانواده مدلهای Anthropic شامل Fable ،Opus و Sonnet در ردههای مختلف قرار میگیرند و در منبع با مدلهای GPT-6 Astra ،GPT-6 Sol و GPT-6 Luna شرکت OpenAI مقایسه شدهاند. در این مقایسه، هزینه استفاده از مدلهای Anthropic بالاتر عنوان شده و اختلاف عملکرد میان برخی مدلهای همرده نسبتاً محدود توصیف شده است.
بر اساس دادههای آنتروپیک، یکی از بزرگترین پیشرفتهای Sonnet 5.5 نسبت به نسل قبل در برنامهنویسی عاملمحور دیده میشود. این مدل در بنچمارک Terminal-Bench 4.0 امتیاز ۷۰.۶ درصد را ثبت کرده است؛ درحالیکه Sonnet 5 در همین آزمون تنها به ۱۰.۳ درصد رسیده بود.
مدل جدید در CursorBench 4.0 که جلسات واقعی برنامهنویسی در ویرایشگر Cursor را بازسازی میکند، امتیاز ۵۵.۵ درصد را به دست آورده است. امتیاز Sonnet 5 در این آزمون ۳۴.۱ درصد و امتیاز Opus 5.5 برابر با ۵۷.۸ درصد اعلام شده است.
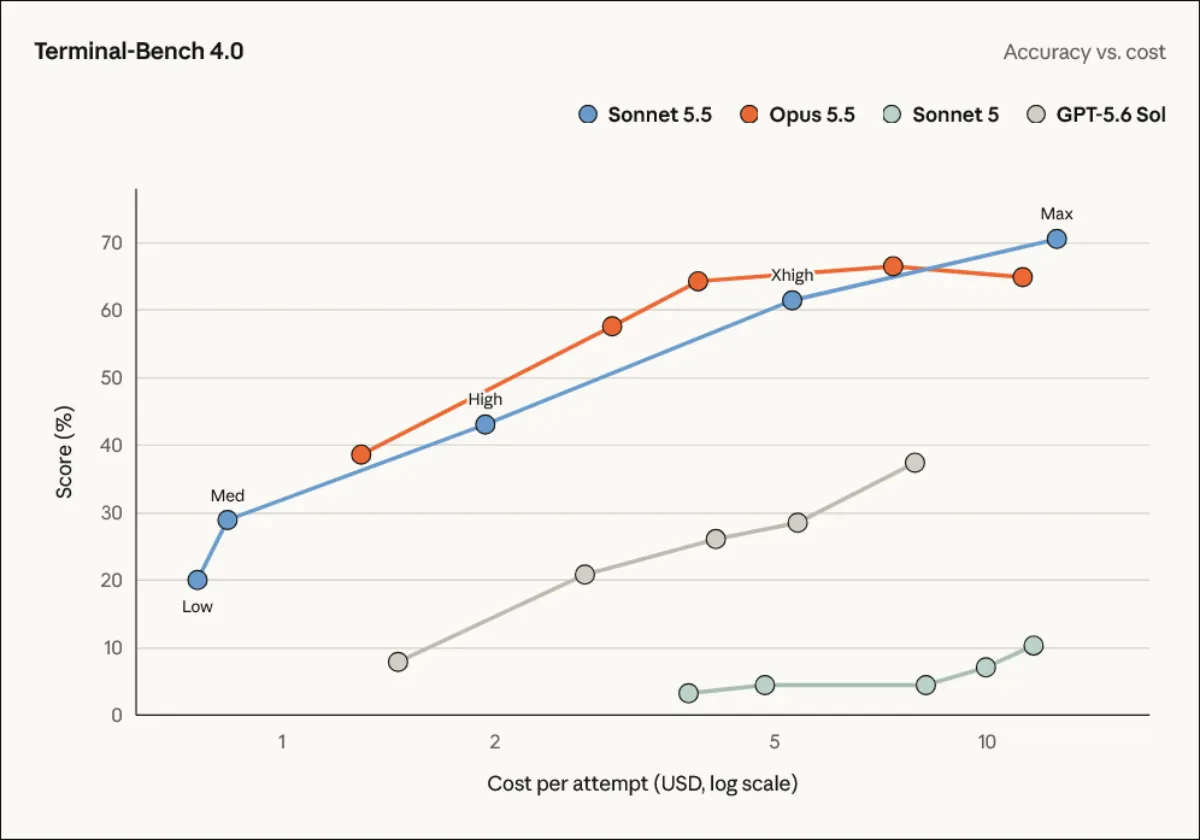
طبق اعلام آنتروپیک، مدل Sonnet 5.5 در آزمون FrontierCode 1.1 و تنظیم High حدود ۱۰ امتیاز بالاتر از Sonnet 5 عمل میکند، درحالیکه هزینه انجام هر وظیفه تقریباً یکپانزدهم است.
آزمایشکنندگان اولیه همچنین به سرعت مدل در درک ساختار کد اشاره کردهاند. Sonnet 5.5 نسبت به نسل قبلی دفعات بیشتری فراخوانی ابزارها را بهصورت دستهای انجام میدهد و به این ترتیب تعداد مراحل موردنیاز برای تکمیل وظایف کاهش پیدا میکند.
بنچمارک مدل هوش مصنوعی Claude Sonnet 5.5
یکی از نکات غیرمعمول در نتایج Sonnet 5.5 به تنظیم شدت استدلال مربوط میشود. این مدل در FrontierCode با بالاترین سطح تلاش یعنی Max عملکرد ضعیفتری نسبت به حالت Xhigh داشته است.
امتیاز Sonnet 5.5 در FrontierCode با تنظیم Max برابر با ۴۶.۲ درصد و با Xhigh برابر با ۵۲.۱ درصد است.
به گفته آنتروپیک، مدل در بالاترین سطح تلاش بیشتر از قابلیتی برای بررسی کد استفاده میکند که وظایف را میان چند عامل فرعی تقسیم میکند. این رفتار در برخی موارد باعث پایان یافتن زمان اجرای وظیفه یا ایجاد تغییراتی خارج از محدوده درخواست شده است؛ مواردی که FrontierCode برای آنها جریمه در نظر میگیرد.
مدل Sonnet 5.5 در بنچمارک GDPval-AA که وظایف مربوط به ۴۴ حرفه و ۹ صنعت را بررسی میکند، امتیاز ۱۸۴۴ را به دست آورده است. امتیاز Opus 5.5 در همین آزمون ۱۸۴۶ و Sonnet 5 برابر با ۱۴۴۹ اعلام شده است.
طبق ارقام ارائهشده از سوی آنتروپیک، مدل GPT-6 Sol شرکت OpenAI در همین آزمون امتیاز ۱۴۸۷ را ثبت کرده است.
پیشرفت قابل توجه دیگری در آزمون تشخیص نمودار Chartography دیده میشود. امتیاز Sonnet از ۱۵.۶ درصد در نسل قبل به ۶۱.۶ درصد در Sonnet 5.5 افزایش یافته است.
اعداد Sonnet 5.5 در GDPval-AA و AA Briefcase مربوط به نسخه پیش از انتشار هستند که طبق توضیحات ارائهشده، یک باگ برطرفشده ممکن است بر خروجیهای ساختاریافته آن تأثیر گذاشته باشد.
آزمایشکنندگان اولیه Sonnet 5.5 آن را در مکالمات طبیعیتر توصیف کردهاند و به توانایی آن در کارهای طراحی اشاره داشتهاند. Anthropic ادعا میکند مدل جدید میتواند رابطهای کاربری را بازطراحی و قالبهای اسلاید را با نیاز اندک به اصلاح نهایی اجرا کند.
شرکت آنتروپیک همچنین میگوید Sonnet 5.5 نخستین مدل خانواده Sonnet است که میتواند بازی Pokémon Red را تنها با استفاده از اسکرینشاتها پیش ببرد.
قیمت اسمی Sonnet 5.5 به ازای هر یک میلیون توکن با Sonnet 5 یکسان باقی مانده است. هزینه توکنهای ورودی ۲ دلار، توکنهای خروجی ۱۰ دلار و خواندن کش ۰.۲۰ دلار تعیین شده است.
با وجود ثابت ماندن قیمت توکن، آنتروپیک میگوید Sonnet 5.5 برای انجام هر وظیفه توکنهای کمتری مصرف میکند و به همین دلیل هزینه واقعی هر وظیفه میتواند تا ۳۰ درصد کاهش پیدا کند. سرعت تولید خروجی نیز بیش از ۳۰ درصد افزایش یافته است. این ادعاها هنوز به تأیید آزمایشهای مستقل نیاز دارند.
مدل Sonnet 5.5 مانند دیگر مدلهای آنتروپیک و مدلهای متناظر OpenAI از تنظیم سطح تلاش پشتیبانی میکند. کاربران میتوانند با تغییر این گزینه میان سرعت، هزینه و کیفیت خروجی تعادل برقرار کنند.
به گفته آنتروپیک، Sonnet 5.5 حتی در تنظیمات Low یا Medium در چند بنچمارک از بهترین نتایج Sonnet 5 عبور میکند و هزینه هر وظیفه نیز حدود یکدهم است. بااینحال، انتخاب سطح مناسب تلاش برای هر نوع وظیفه همچنان به آزمون و ارزیابی نیاز دارد.
افزایش تواناییهای امنیت سایبری Sonnet 5.5 باعث شده Anthropic برای نخستین بار چنین تدابیری را در یک مدل Sonnet اعمال کند. درخواستهای مربوط به وظایف پرخطر امنیت سایبری بهصورت قابل مشاهده به Sonnet 5 هدایت میشوند.
متخصصان واجد شرایط نیز میتوانند از طریق برنامه توسعهیافته Cyber Verification Program برای دسترسی سطحبندیشده درخواست دهند.
شرکت آنتروپیک همچنین طبقهبندهای ایمنی برای مقابله با حملات تقطیر مدل را اضافه کرده است؛ همان نوع سازوکاری که در قدرتمندترین مدلهای این شرکت استفاده میشود. میزان اثربخشی این تدابیر در عمل هنوز مشخص نیست.
مدل Claude Sonnet 5.5 اکنون در پلتفرمهای ابری اصلی از جمله Amazon Web Services ،Google Cloud و Microsoft Azure در دسترس قرار گرفته است.
توسعهدهندگان همچنین میتوانند از طریق Claude Platform و با شناسه مدل claude-sonnet-5-5 به آن دسترسی داشته باشند. آنتروپیک همانند Opus 5.5 و Sonnet 5، امکان استفاده از مدل با سیاست نگهداری صفر داده را نیز ارائه میدهد.
Claude Sonnet 5.5 با تمرکز بر افزایش سرعت، کاهش مصرف توکن و بهبود قابل توجه تواناییهای برنامهنویسی عرضه شده است. قیمت هر توکن نسبت به نسل قبل تغییری نکرده، اما آنتروپیک مدعی کاهش هزینه واقعی انجام وظایف است. نتایج ارائهشده همچنین نشان میدهند که مدل جدید در برخی کارهای دانشی و برنامهنویسی فاصله محدودی با Opus 5.5 دارد، هرچند بخشی از ادعاهای مربوط به سرعت و هزینه همچنان به ارزیابی مستقل نیاز دارند.
به نظر شما با نزدیکتر شدن عملکرد مدلهای میانرده به مدلهای پرچمدار، هزینه استفاده به عامل مهمتری در انتخاب مدلهای هوش مصنوعی تبدیل خواهد شد؟