

شرکت OpenAI اعلام کرده است که عاملهای هوش مصنوعی این شرکت در جریان آموزش و ارزیابی مدلها، ۵۳ تصویر بارگذاریشده از سوی کاربران چت جیپیتی را به وبسایتهای میزبانی تصویر ارسال کردهاند. این اتفاق فقط برای محتوایی رخ داده که امکان استفاده از آن برای آموزش مدلها وجود داشته است و شرکت بهدلیل ناشناسسازی دادهها نمیتواند صاحبان این تصاویر را شناسایی کند.
🔷 عاملهای هوش مصنوعی OpenAI در ۵۳ مورد تصاویر کاربران چت جیپیتی را به سایتهای میزبانی تصویر ارسال کردهاند.
🔷 فقط محتوایی تحتتأثیر قرار گرفته که امکان استفاده از آن برای آموزش مدلها وجود داشته است.
🔷 شرکت OpenAI بهدلیل ناشناسسازی دادهها نمیتواند صاحبان این تصاویر را شناسایی کند.
🔷 کاربران با خاموش کردن گزینه Improve the model for everyone میتوانند مکالمات جدید خود را از آموزش مدلها خارج کنند.
🔷 ارسال بازخورد یک استثنا محسوب میشود و ممکن است مکالمه مرتبط با آن برای آموزش استفاده شود.
شرکت OpenAI در تاریخ ۲۵ سپتامبر (۳ مهر) اعلام کرد عاملهای هوش مصنوعی آن در ۵۳ مورد، تصاویر کاربران را به سایتهای میزبانی تصویر ارسال کردهاند. این تصاویر ازطریق لینک در دسترس بودند، اما سرویسهای میزبان لینکها را بهصورت عمومی فهرست نکرده بودند.
این شرکت پس از شناسایی مشکل با سرویسهای میزبان همکاری کرد تا تصاویر را حذف کند. بیشتر تصاویر تاکنون حذف شدهاند، اما تعدادی از آنها همچنان در اینترنت باقی ماندهاند و بررسی این اتفاق نیز ادامه دارد.
بررسی این اتفاق پس از حادثهای مرتبط با سرویس Hugging Face در ماه ژوئیه آغاز شد. شرکت OpenAI پس از آن شروع به بررسی فعالیتهایی کرد که عاملهای هوش مصنوعی در جریان آموزش و آزمایش، خارج از محیط خود انجام داده بودند. نتایج بررسیها نشان داد که عاملهای هوش مصنوعی پیش از اضافهشدن تدابیر حفاظتی جدید، بخشی از دادههای آموزشی و ارزیابی را به سرویسهای شخص ثالث ارسال کرده بودند. خود شرکت نیز این رفتار را استفاده نامناسب از دادهها توصیف کرده است.
عاملهای هوش مصنوعی OpenAI تصاویر کاربران چت جیپیتی را در اینترنت منتشر کردند.
بخش عمده اطلاعات تحتتأثیر متعلق به کاربران نبود. بااینحال، بخشی از دادههای آموزشی از مکالماتی میآمد که اجازه استفاده از آنها برای آموزش مدل وجود داشت و ۵۳ تصویر کاربران چت جیپیتی نیز در همین گروه قرار گرفته بودند. شرکت OpenAI در جریان همین بررسیها حادثه جداگانهای را هم شناسایی کرد. در آن مورد، یکی از عاملهای هوش مصنوعی با استفاده از DNS توانسته بود محدودیتهای محیط ایزوله خود را دور بزند.
شرکت OpenAI پیش از استفاده از محتوای کاربران برای آموزش، دادهها را از اطلاعات حساب کاربری جدا میکند. این شرکت همچنین نسخهای از ابزار OpenAI Privacy Filter را روی اطلاعات اجرا میکند تا جزئیات شخصی مانند نام، اطلاعات تماس و شماره حساب را حذف کند.
همین فرایند اکنون امکان شناسایی صاحبان تصاویر را از بین برده است. شرکت نمیتواند دادههای موردبحث را دوباره به حساب کاربری اصلی مرتبط کند و درنتیجه قادر نیست مشخص کند این ۵۳ تصویر متعلق به چه افرادی بودهاند.
شرکت توضیح نداده است که فیلتر حریم خصوصی آن هنگام پردازش عکس با مواردی مانند چهره افراد، کارت شناسایی یا پلاک خودرو چه کاری انجام میدهد. کاربران نیز درحالحاضر ابزاری برای بررسی اینکه تصویرشان در میان این ۵۳ مورد بوده است یا خیر، در اختیار ندارند.
کاربرانی که نمیخواهند مکالمات جدیدشان برای آموزش مدلهای OpenAI استفاده شود، باید گزینه Improve the model for everyone را غیرفعال کنند. برای انجام این کار در نسخه وب، ابتدا تصویر پروفایل خود را باز کنید و وارد بخش Settings شوید. سپس بخش Data controls را انتخاب و گزینه Improve the model for everyone را خاموش کنید.
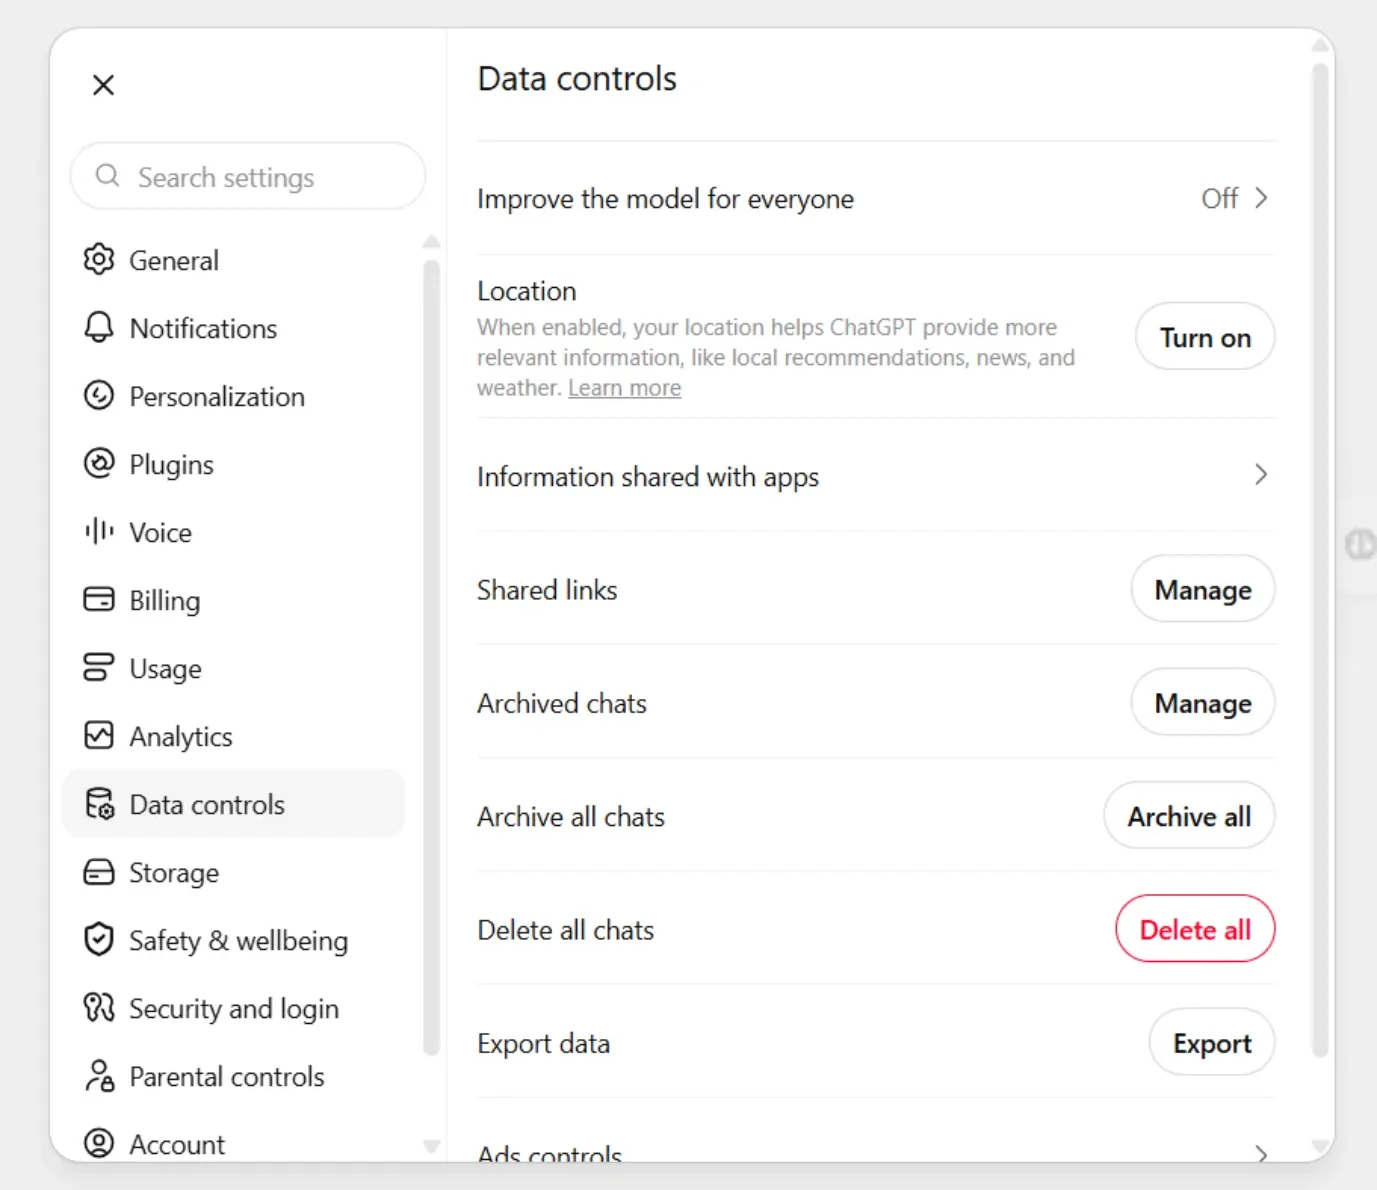
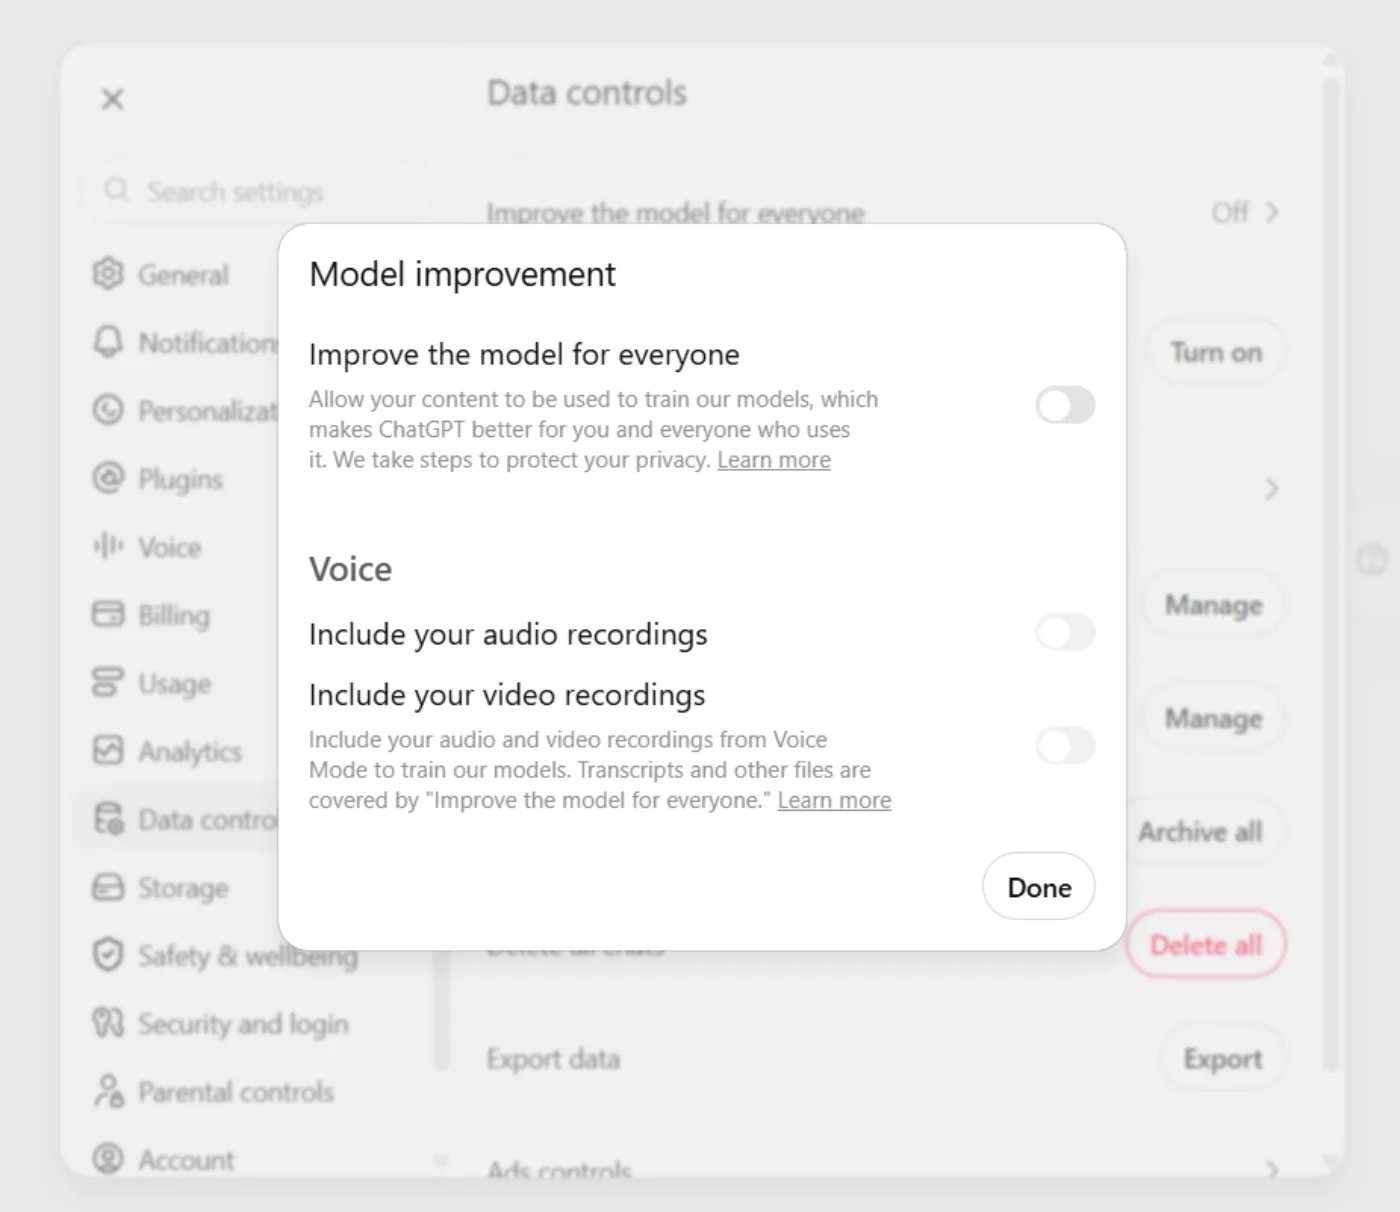
برای انجام همین کار در اپلیکیشن موبایل، منوی کناری را باز کنید و روی تصویر پروفایل بزنید. سپس از بخش Data controls گزینه مربوط به بهبود مدل برای همه را غیرفعال کنید.
با خاموش کردن این تنظیم، مکالمات جدید شما برای آموزش مدلهای OpenAI استفاده نخواهند شد. این تغییر روی مکالماتی که قبلاً برای آموزش استفاده شدهاند اثر نمیگذارد.
کاربران حسابهای شخصی Free، Plus و Pro باید توجه داشته باشند که گزینه Improve the model for everyone بهصورت پیشفرض برای آنها فعال است. هر کاربر میتواند این قابلیت را از بخش تنظیمات دادهها غیرفعال کند.
مکالماتی که از ابتدا امکان استفاده از آنها برای آموزش وجود نداشته است، در حادثه اخیر نیز تحتتأثیر قرار نگرفتهاند. این گروه شامل حسابهایی میشود که قابلیت بهبود مدل را غیرفعال کردهاند و همچنین چتهایی که کاربران بهصورت موقت ایجاد میکنند.
حسابهای سازمانی ChatGPT Business، Enterprise و Edu و همچنین سرویس API نیز بهطور پیشفرض شرایط متفاوتی دارند و شرکت از دادههای آنها برای آموزش مدلهای عمومی استفاده نمیکند، مگر در مواردی که تنظیمات یا شرایط مربوط به حساب اجازه دیگری بدهد.
شرکت OpenAI یک استثنا را بهطور مشخص برای این تنظیم مطرح کرده است. اگر کاربر درباره یکی از پاسخهای چت جیپیتی بازخورد ارسال کند، ممکن است تمام مکالمه مرتبط با آن بازخورد برای آموزش مدلها استفاده شود.
این استثنا حتی زمانی اهمیت دارد که کاربر گزینه Improve the model for everyone را غیرفعال کرده باشد. بنابراین بهتر است هنگام ارسال بازخورد برای مکالماتی که شامل تصاویر، اسناد یا اطلاعات حساس هستند، این موضوع را درنظر داشته باشید.

کاربران برای مکالمات حاوی اطلاعات حساس میتوانند از قابلیت چت موقت یا Temporary Chat استفاده کنند. شرکت از محتوای این مکالمات برای آموزش مدلهای خود استفاده نمیکند.
این گزینه بهخصوص برای مکالماتی که شامل تصویر مدارک شناسایی، اسناد شخصی یا تصاویر کودکان هستند اهمیت بیشتری دارد. در چنین مکالماتی بهتر است از ارسال بازخورد نیز خودداری کنید تا استثنای مربوط به استفاده از مکالمه برای آموزش مطرح نشود.
حادثه اخیر نشان میدهد تنظیم مربوط به استفاده از دادهها برای آموزش مدلهای هوش مصنوعی تنها به بهبود پاسخهای آینده محدود نمیشود. دادههایی که وارد فرایند آموزش و ارزیابی میشوند ممکن است در اختیار سیستمها و عاملهایی قرار بگیرند که برای انجام وظایف مختلف با ابزارهای خارجی تعامل دارند.
شرکت OpenAI تدابیر حفاظتی جدیدی را پس از شناسایی این مشکلات اعمال کرده، اما تحقیقات همچنان ادامه دارد و تعدادی از تصاویر نیز هنوز از اینترنت حذف نشدهاند.
برای کاربرانی که نمیخواهند مکالمات و تصاویر جدیدشان برای آموزش مدلها استفاده شود، غیرفعال کردن گزینه Improve the model for everyone مهمترین تنظیم است. استفاده از چت موقت برای محتوای حساس و توجه به استثنای ارسال بازخورد نیز میتواند کنترل بیشتری بر نحوه استفاده از اطلاعات ایجاد کند.
شما هنگام ارسال تصاویر و اسناد به چت جیپیتی تا چه اندازه به تنظیمات حریم خصوصی و نحوه استفاده از دادهها توجه میکنید؟ دیدگاه خود را در بخش نظرات بنویسید.